ラベル ChIP-Seq / RNA-Seq の投稿を表示しています。 すべての投稿を表示

2011年12月20日火曜日

キメラRNAの検出

NGSでキメラRNAの検出に挑戦した論文

Kannal et al. Recurrent chimeric RNAs enriched in human prostate cancer identified by deep sequencing PubMed

Q: Chimeric RNAって、Fusion Geneのことでしょうか?

A: もっと広い概念です。 Chimeric RNAのうち、Chromosomal Rearrangementsによって作られる複合遺伝子のことを、Fusion Geneと定義するそうです。

染色体リアレンジメント以外の原因で、転写が原因で作られるキメリックな転写産物のことも、Chimeric RNAと呼ぶそうです。

転写が原因で起こる? 
  • 隣の下流遺伝子まで、転写されてしまうことで作られる、Read-through/splicing 型Chimeric RNA
  • 転写された異なるRNA分子が同時にスプライシングされて、ひとつのRNA分子になる、Transsplicing 型Chimeric RNA
このような種類のChimeric RNAがあるそうです。
そのうち、前立腺癌に特徴的なキメラRNAを見つけよう!という論文です。

NGSはスクリーニングに使う、というスタンスです。
いくつもフィルタリングを重ねて、キメラRNAの候補を絞り込んでいます。
イルミナGAIIの36bpペアエンドリードを使っています。
  
  1. クオリティフィルター: リード単位でクオリティが悪いもの(イルミナパイプラインのデフォルト)を除きます
  2. ユニークネスフィルター: リードマッピングの後、マッパブルなペアエンドリードのうち、ペアとして、ゲノムまたはTranscriptに複数個所マップするものを除きます。 これによって、ペアリードの両方とも、ゲノム上またはTranscript上に1か所だけマッピングするものだけが残ります(2塩基のミスマッチはゆるしています)。  
  3. Entrez Gene IDフィルター: ゲノムやTranscriptにユニークにヒットすると言っても、遺伝子単位でユニークかどうか。 彼らは、Entrez Gene ID単位で遺伝子を定義しています(Gene IDが無い配列は遺伝子としない)。 ペアとして複数のGene IDにマップされるリードは除かれます。  この2と3のフィルタリングは、ユニークマッピングするペアリードだけを残すので、Gene Family(Homolog)などを間違ってキメラRNA候補としてしまうのを避けることができます。 しかし、逆に、Homologのどれかがキメラっている場合のRNAは検出できません。 実際、CLC Genomics Workbench でも経験があるのですが、Fusion Geneを検出してもHomologにばかりヒットして、擬陽性ばかりということがありました。 ユニークヒットに限ることは良いかもしれません。
  4. Gene ID キメラフィルター: キメラRNAを見つけるのが目的なので、同じ遺伝子上にペアの両方ともマップされているリードは除きます。 異なる遺伝子をまたいでマップされているリードだけに絞っています。  イメージでは、こんな感じ(Fusion Geneと書いていますがキメラRNAと置き換えてください) 

ペアの片方が、偶然GeneAとGeneBの結合部位(ジャンクション)に合った場合、片方のペアの6塩基が完全ヒットであれば、ジャンクションにヒットしたと、見なしていました。
個人的にはもう少し長い塩基の条件にした方が良いのでは、と。

彼らは、少なくとも3本のペアリードが、同じキメラRNAの相手にマップされていた、という条件で、 6,163ものキメラ候補を3人の患者サンプルから得ました。
そのうち、後に検証しにくいKLK2またはKLK3を含むキメラを除くと、2,369にまで減りました。
20人の患者中10人に共通していたキメラは46と、ウェットで検証可能な数になりました。


世の中には、TopHat Fusionというツールがありますが、この論文では使われていないようです。


2011年11月4日金曜日

RNA-Seqのカウントって....どうする?

“ There are known knowns; there are things we know we know.
We also know there are known unknowns; that is to say we know there are some things we do not know.
But there are also unknown unknowns -- the ones we don't know we don't know."

これは2002年 2月12日、記者から、イラクにあるとされる大量破壊兵器がテロリストの手に渡ったという確かな証拠が無いことを指摘されて、これに答えたドナルド・ラムズフェルド国防長官(当時)の言葉です。
当時、あまりに意味難解な返答に、たくさんのコメディアンがジョークのネタにしていたことを覚えています。

既知なこと、知っていること、わかっていること。 これらが存在することを知っていること、わかっていること。
わからないことがあるということを知っていること。 あるいは知らないこと。
・・・哲学的ですね。 

これとRNA-Seqとが何の関係があるかというと、ノーマライズの方法について、知っていることと知っていると仮定していること、知らないこと、をちゃんと知っておく必要があるからです。

タグの数から発現量を算出する時の、RPKMという方法を以前書きました。

RPKMでは、タグカウントを、サンプル内の全カウントで割って、さらに転写産物の長さで割って、定数を乗じて、ノーマライズするのでした。
くわしくはWikiなどを参照。

ここで、
タグ(リード)数はKnownですか?
サンプル内総タグ数はKnownですか?
転写産物の長さはKnownですか?

Isoformの存在、未知Exonの存在などを加味すると、転写産物の長さは、厳密にはUnknownですね。 しかしこれをKnownと仮定して、計算します。
タグ数も、この仮定の転写産物の長さにマップされた数としてカウントされるのですから、厳密にはUnknownです。
こうなってくると、サンプル内総タグ数は、転写産物にMappableなタグという意味では、Knownとするべきでしょうか?

とは言っても、転写産物の長さを厳密に認識するのは、ショートリードでは不可能ですから、みなさんRefSeqなどで公開されている既知のmRNAの長さを用いるのです。 
でも頭のどこかに、これは仮定の長さかもしれない、と覚えておくのは意味があるでしょう。

さて、
複数サンプル間で発現量を比較したいとき、遺伝子の長さがとても影響するということがわかっています。
Oshlack et al., Transcript length bias in RNA-seq data confounds systems biology. Biology Direct 2009, 4:14.
 
転写産物が長い遺伝子ほど、異なるサンプル間で発現量の変動が大きく計算される傾向があるのです。
この論文では遺伝子の長さで補正していません。 発現変動の大きさと、遺伝子の長さをそれぞれ軸にプロットすると、発現変動の大きい遺伝子ほどmRNAが長い遺伝子だということがわかったそうです。
aとcがRNA-Seqのデータで、縦軸があるしきい値で発現変動ありとされた転写産物の割合(%)、横軸がその転写産物の長さ(bp)です。 bは同じくマイクロアレイのデータです。
RNA-Seqの「発現変動ありとする」やりかたに問題があるのは、長い遺伝子ほど変動ありとされている遺伝子の割合が高いことから、明らかです。

そこで、RPKMのように転写産物の長さで補正することが必要になるのですが、これまた、RPKMも万能ではありません。
つづく

2011年7月22日金曜日

Trinity: de novo Transcriptome の救世主?

前回の最後にチョイ出ししたTrinityというソフト、使ってみました。
http://trinityrnaseq.sourceforge.net/
Broad Instituteで開発されたこのソフトは、Perlで動かして使い、Linux上でテストされているそうです。
先のサイトからダウンロードしてインストールすると、
こんなディレクトリができあがり、/trinityrnaseq/sample_data/test_Trinity_Assembly の下に、サンプル用のペアエンドデータが作られているはずです。

とりあえずどんな結果が出てくるのかが待ち遠しいひとは、まずこのサンプルデータをランしてみましょう。 runMe.sh を打つようにマニュアルでは言っていますが、あえて(わざわざ)このシェルの中のコマンドを打ってみました。 (以下、一行です)

Trinity.pl --seqType fq --left reads.left.fq --right reads.right.fq --SS_lib_type RF --paired_fragment_length 280  --min_contig_length 305 --run_butterfly  --CPU 2 --bfly_opts "-V 10 --stderr"
  • --seqType fq で、このリードがFastqだということを示し、
  • --left / --right で、ペアエンドの配列ファイルを指定し、
  • --SS_lib_type RF で、このリードがストランドスペシフィック(日本語で何と訳すんだろう)でリバース・フォワードの向きだと宣言し、
  • --paired_fragment_length 280 はフラグメントの長さが280ベースだと言い、
  • --min_contig_length 305 で、コンティグは最低305塩基必要とし、
  • --run_butterfly --CPU 2 で、一緒にbutterfly もランして、その時はCPUを2個使えと言い、
  • --bfly_opts "-V 10 --stderr" これは何かよくわかりません
ちなみにシングルエンドリードのときは、--left / --right を --single にすればOKです。
さて、このコマンドを流すと、trinity_out_dir というディレクトリが作られて結果が保存されますが、--output で出力先を決めることもできます。

結果で大事なのは、この中でTrinity.fastaです。 これが最終的なコンティグです。


これがそのファイルを開いたところです。 名前(ID)と、Contigの長さ、リードをマッピングした時のFPKM、がヘッダーに書かれているMulti-Fasta形式ですね。


Trinityは、Inchworm(シャクトリ虫)、Chrysalis(サナギ)、Butterfly(チョウ)という名前の3つに分かれています。
Inchwormでは、k-mer ベースでの de Bruijn graph でアセンブります。 Alternative Variantがある時でも、そのうちの代表的な転写産物をつくるようにアセンブるので、完全なTranscriptome、Isoformを反映したTranscriptomeができるわけではありません。 
デフォルトは k=25 です。 k-1 の重なりでContigを伸長していき、これ以上伸長しなくなったら止まるそうです。
Inchworm.K25.L48.fa という名前のファイルができます。 
メモリが足りないとこのファイルすらできません。

次のChrysalisは、名前の通り、動いているのか止まっているのかわからない、ユーザーを不安にさせるコマンドです。
冗談です。
Inchwormで作られたInchworm.K25.L48.fa のコンティグたちから似ている配列のContigを集め、Alternative Splicingや、Paralogっぽい配列をまとめる、極めて重要な作業をしている、そうです。
k-1 の重なり具合をもとに、Inchwormで出来上がったコンティグで、de Bruijn graph を作っていくつものパスを作るらしいです。

最後のButterflyは、いかにもチョウらしく、何百行ものコマンドラインが現れては流れていきます。 ChrysalisでまとめられたIsoform/Paralogのコンティグをもとに、リード配列を使って、あいまいさの残る部分を修正し、全体を再構築しているそうです。 
この過程でFPKMも算出されます。

文献によると、ベンチマークでは、ABySS、TransABySS、SOAP denovo、と比べると、完全長の遺伝子、Isoformの数ともにTrinityは優れているそうです。

しかーし、

このツールは恐らくショートリード向けでしょう。 k-mer が25と短いのがその理由です。

また、デモデータではなく、本番データをアセンブるには、結構な量のメモリが必要です。
76塩基程度のイルミナペアリード100万本あたり、1GB のメモリが必要だそうです。
とうことは、1,000万本で10GB、1億本で100GB !!!
彼らのお勧めは、256GB の、22コアCPUのサーバーとのこと。
とてもじゃないですが、常識的なお値段で買える代物ではありません。

と、いうことで、私は多分、リード数が2,000万本を超えるような de novo Transcriptome でこのツールを使うことはしないでしょう。 
分散化などをうまく施せば別ですが。


2011年7月18日月曜日

de novo Transcriptome; 454用のベストなアセンブラーはどれだ !? 【論文紹介】

Roche 454 と言えば、パイロシーケンスでロングリードを読める代表格です。
数百塩基も読めるロングリードは、未知の配列決定にも良く使われます。
de novo のシーケンスですね。
以前、de novo Transcriptome を話題にしましたが、リファレンスが未知の生物で、転写産物配列を決定したい場合、ロングリードの454が、真っ先に使うシーケンサーの候補に挙げられるでしょう。
もちろんショートリードのペアエンドで読む、ということも可能です。
しかし、長く読めるということは、未知の配列決定において非常に大きなアドバンテージですので、454を選ぶ方は多いのです。

ゲノムではなく、転写産物を読む場合、Isoformの存在が気になります。
スプライシングのバリアントを見たい場合、やっぱりロングリードが有利でしょうか。

実は、リファレンス未知の生物のTranscriptomeを行っている研究は、結構あります。
論文になっているものだけでも、昨年紹介した、ほかにも、

Coral larval (サンゴ): Meyer et al. BMC Genomics 10, 219 (2009).
Eucalyptus grandis (グランディスユーカリ): Novaes et al. BMC Genomics  9, 312 (2008).
Sarcophaga crassipalpis (ニクバエ) : Hahn et al. BMC Genomics 10, 234 (2009).
Populus trichocarpa (ブラックコットンウツド): Geraldes et al. Mol.Ecol.Resour 11, 81 (2011).

なんかがあるようです。 (全部は読んでいませんが)

454のリードは一般的には、シーケンサーの機械に付属しているアセンブラー、Newblerでアセンブルすることが多いと思います。
でも、Newbler以外にも、ロングリードをアセンブルできるアセンブラーはいくつかあるんですよ。
そこで、454のリードをアセンブルできるアセンブラーを比較した論文を紹介します。
Kumar et al. Comparing de novo assemblers for 454 transcriptome data. BMC Genomics 11, 571 (2010).
この論文は2010年に出されていますから、今年は各ソフトもバージョンアップして、論文投稿時とは若干状況が違っていると思いますが、参考になると思います。

比較しているアセンブラーは、
  1. Newbler 2.3
  2. Newbler 2.5
  3. CAP3
  4. CLC Assembly Cell 3.0
  5. MIRA 3.0
  6. SeqMan NGen 2.1
の6つです。 CLCとSeqManは商用ソフト、Newblerはアカデミックはフリー、CAP3は非営利ならフリー、MIRAはどこでもフリー、だそうです。 
結論からいうと、Newbler 2.5が最も良いとのこと。
「454のシーケンスメーカーが作っているんだから当たり前だろ!」
私も思わず突っ込みましたが、ほかにも面白いことが書いてあるかと。

アルゴリズムの違いとして重要なところは、
CLCはde Bruijn graphを、その他の5つはOverlap-Layout-Consensus (OLC) を使っていること。

de Bruijn graphはVelvetやABySSといったアセンブラーでも使われています。
de Bruijn graphの特徴は、リードをk-merという決められた長さの塩基ブロックに切り、この部分の重なりをもとに、アセンブルをします。
k-mer = 31なら31塩基の重なりを見て、リード同士をつなげていきます。
k-merの範囲でのみ重なり具合を見るんですね。 本当はショートリードの、たくさんカバレージがあるデータに向いています。
一方OLCはクラシカルな方法?で、ペアワイズアライメントを元にしています。
より慎重に伸長していくのですね。
もちろん、6つのアセンブラーはそれぞれ、計算アルゴリズムを工夫しているので、結果はちがうのですが。

この論文では、彼らは線虫の一種をサンプルに、Roche 454 FLX を使って de novo Transcriptome をやっていました。
アダプタートリムした 741,387本のリード、約2億塩基のデータを、先の6つのアセンブラーでアセンブルしています。

最も速くアセンブルが終わったのは、CLCで4分、次がNewbler 2.5の45分。 一番遅いのがMIRAの3日。
1kb以上の長さのContigが一番多くできたのは、Newbler 2.5で7,661本、次がNewbler 2.3の6,320本。 一番少ないのはCLCの4,174本。
全Contigの合計塩基数は、一番多いのがSeqManの2,136万塩基、次がMIRAの2,134万塩基、3位はNewbler2.5の2,007万塩基。 最も少ないのはNewbler 2.5の1,446万塩基。
(詳細は同論文のTable4を参照)

Contigの合計塩基数でNewblerのバージョン2.5と2.3で成績が全然違うのにはびっくりします。
2,007万塩基と1,446万塩基ですからねえ。

6つのアセンブラーでできたContigをそれぞれBLATして、相似性・非相似性を調べ、新規配列がどれだけ作られたか、を彼らは次に見ています。
結果、MIRAとNewbler2.5は、より多くの(長い)ContigをCLCやCAP3より作ったが、その余分の配列は特に新規の配列ではなかった。 曰く、MIRAとNewbler2.5のContigには冗長性があるのではないか、と。
CLCのcontigは最も冗長性が低かったらしい。 ということは余分な配列は作らなかった。 
「待てよ、それって良いことなのか? TranscriptomeではIsoformはつきもの。」

繰り返しですが、
de Burijn graph は高カバレージの大量リードアセンブルに向いています。 なぜならアセンブルがめっちゃ速いから。
OLCは低カバレージのアセンブルに向いています。 なぜなら正確だけど、ペアワイズアライメントなので計算量がかかるから。

私の経験でも、CLCの de Burijn graph アセンブラーは他と比べて速いです。
でも、速いがゆえに、犠牲にしていることがあります。
  1. アセンブルに使われたリードの情報(どのリードがどのContig形成に用いられたか等の情報)は持たない。 他のアセンブラーではACEファイルというものを持つようです。
  2. k-mer は最大でも31です。 これはCLCの設定です。 31塩基は、ショートリードには向いているかもしれませんが、400塩基を超すようなロングリードでは短いですし、結果、Contigが断片化してしまうことがあります。
  3. Isoformの認識は失われる。 CLCのde Burijn graphの宿命です。 Contigが途中から枝分かれするようなとき、「枝」は別のContigとされます。 これを修正しているアルゴリズムは別途紹介します。
しかし、4分という速さは驚くべきことで、「とりあえずやってみよう」的な使い方には向いているでしょう。

現在、MiSeqやPGMに代表されるように、より多くの、ロングリードが出てくるようになってきています。 OLCアルゴリズムでは今後、計算速度が大きな壁になるでしょう。
ちなみにこの論文では、64bit Linuxの、普通のワークステーションレベルのPCを使っていました。


さて、同じ de Bruijn graph でも、Isoformを見つけよう! パラログを認識しよう!というコンセプトのアセンブラーが最近出てきました。
454のようなロングリードではなく、ショートリード用ですが、Trinityというものです。

http://trinityrnaseq.sourceforge.net/

最近使い始めたばかりですので、このツールについてはまたの機会に。


2011年6月14日火曜日

FPKM、RPKM

FPKMとRPKM、似ているようだが一体何なのか。

TopHat-Cufflinks の発現解析パイプラインでは、発現量をFPKMという方法で表していました。
もともとこれと似たようなものに、RPKMがあります。

FPKMは、Fragments Per Kilobase of exon per Million mapped fragments の略、
RPKMは、Reads Per Kilobase of exon per Million mapped reads の略です。
FragmentsかReadsかの違いだけですね。 言わんとすることは殆ど同じです。

つまり、ノーマライズした発現量 です。

もうちょっと詳しく言うと、例えば、
SAMPLE1とSAMPLE2、という、別のレーンでランをしたサンプルがあるとします。
Sample1では、リファレンス全体にマップされたリードが1000万本、Sample2では2000万本、ありました。
ここでGeneAに注目すると、Sample1では200本、Sample2では400本のReadが、GeneAにマップされていました。
リファレンス全体にマップされたリードの本数を無視すると、GeneAの発現量は、Sample1:Sample2 = 200 : 400 = 1 : 2 となりますが、これは全体の発現量でノーマライズするべきですね。
マイクロアレイでも、各プローブのシグナルを、全プローブのシグナルの中央値で割って、ノーマライズ(Median Normalize)することがありますが、あれと同じような考え方です。

リファレンス全体にマップされたReadの本数が、仮に100万本だったとき(i.e. 基準を100万本に揃えてノーマライズ)、各々の遺伝子にマップされたReadは何本に相当するか、と。 
これが100万本でノーマライズしたときの、RPM (read per million) です。

さらに、RNA-Seqの場合、各々の転写産物の長さも考慮に入れなければいけません。
長い転写産物はそれだけ多くのReadがマップされるからです。
転写産物の長さは遺伝子によって様々、一方Readの長さは50 baseなら50 baseで一定ですから、長い遺伝子が多くマップされるのは当たり前ですね。
これも仮に、全ての転写産物が1,000 base 長としたとき、マップされたRead本数はいくつに相当するか、を算出することができます。
これが、転写産物1000塩基長でノーマライズしたときの、RPKM (read per kilobase / million)です。
異なる遺伝子間の発現量を比較するときは必須です。

RPKMはReadを単位にしていました。シングルリードで読んだ時はこちら。
FPKMはFragment、ペアエンドで読んだときの2つのReadを1組としたfragment、を単位としています。

尤も、RPKMやFPKMなどでノーマライズしたとしても、Read/fragment のカウンティングの方法によって、発現量の多い転写産物は実際よりもずっと多くカウントされてしまう、などのノイズ・バイアスがかかってくることもありますので、万能ではありません。
最近はそれらノイズを補正するアルゴリズムも公開されていますが、これらについてはまた。
(私も他人に説明できるレベルまで理解しきれていないので、こう言って逃げることをお許し下さい)

RPKMについて: Mortazavi et al. (2008). Mapping and quantifying mammalian transcriptomes by rna-seq. Nat Methods, 5(7):621--628.

FPKMについてはCufflinks等のサイト参照

2011年6月3日金曜日

発現解析パイプラインを作るぞ! その2: TopHat の使い方 2

さて、無事TopHatが終了し、下のような画面が出て、
accepted_hits.bam, junctions.bed, insertions.bed / deletions.bed というファイルができたとしましょう。
この3ファイルが何かについては前回説明しました。
TopHatは、コマンド実行時に指定したgtfファイルを使って、gtfに書かれている既知の転写配列情報から、Exon Junction を認識してマッピングしてくれるのです。

Exon Junctionを認識するということは、Fusion Geneも特定してくれそうです。
それは、Tophat-fusion というツールがあるのですが、また今度別のときに書きます。

さて、うまくマッピングされ、BAMファイルができました。
では次に、Samtools を使って、BAMファイルを染色体番号順にソートします。
これは後で必要になります。

samtools sort ./tophat_SRP003186_Control/accepted_hits.bam ./tophat_SRP003186_Control/sort_accepted_hits
samtools sort ./tophat_SRP003186_MCF7/accepted_hits.bam ./tophat_SRP003186_MCF7/sort_accepted_hits
samtools sort ./tophat_SRP003186_SKBR3/accepted_hits.bam ./tophat_SRP003186_SKBR3/sort_accepted_hits
最後のアウトプットに.bam と書くと、出力が.bam.bam と2重拡張子になるので注意!

次に、後でUCSCとかIGVとかのGenome Viewerで見るために、ソートしたBAMファイルにインデックスをつけておきます。
samtools index ./tophat_SRP003186_Control/sort_accepted_hits.bam
samtools index ./tophat_SRP003186_MCF7/sort_accepted_hits.bam
samtools index ./tophat_SRP003186_SKBR3/sort_accepted_hits.bam
拡張子.bai というファイルができるはずです。 これがインデックスです。

ついでにソートしたBAMファイルを、SAMフォーマットにしておきましょうか? 別に必要無いですけど、samtools に慣れていないひとは練習がてら。 
ちなみにIGVは、SAMファイルも取り込めます。その際には、IGV-toolsでインデックスをつけるひつようがあります。
また、以前紹介した、SAM-Mate というWindows 対応のRNA-SEQ解析ツールは、SAMでないと受け付けてくれません、今のところ。 
samtools view ./tophat_SRP003186_Control/sort_accepted_hits.bam -o ./tophat_SRP003186_Control/Control_sort_accepted_hits.sam
samtools view ./tophat_SRP003186_MCF7/sort_accepted_hits.bam -o ./tophat_SRP003186_MCF7/MCF7_sort_accepted_hits.sam
samtools view ./tophat_SRP003186_SKBR3/sort_accepted_hits.bam -o ./tophat_SRP003186_SKBR3/SKBR3_sort_accepted_hits.sam

 
発現変動を見るには、Cufflinksのコマンドのひとつ、Cuffdiff というものを実行します。
ソートしたBAMファイル、既知トランスクリプトのGTFファイルの2つを使います。
cuffdiff -p 4 -v /Path_to_gtf/refGene.gtf ./tophat_SRP003186_Control/sort_accepted_hits.bam ./tophat_SRP003186_MCF7/sort_accepted_hits.bam -o ./cuffdiff/MCF7
cuffdiff -p 4 -v /Path_to_gtf/refGene.gtf ./tophat_SRP003186_Control/sort_accepted_hits.bam ./tophat_SRP003186_SKBR3/sort_accepted_hits.bam -o ./cuffdiff/SKBR3
コントロール v.s. MCF-7、コントロール v.s. SK BR-3 の2つの比較ですね。
本当はリプリケートがあると良かったのですが、これはN=1です。
パラメータは単純にデフォルトで行っています。
唯一、CUPを -p 4 にしたことくらいでしょうか。

Cuffdiffのアウトプットファイルは地味で、タブ区切りテキストファイルができるだけです。
もちろん加工すればGenome Viewer上でも表示できますが。
FPKM tracking ファイルと、Differential expression 結果ファイルの2種類があります。

1) FPKM tracking ファイル: トランスクリプトごとのFPKMを出力し、各cuffdiffランごとに4ファイルできる
isoforms.fpkm_tracking: Transcript FPKMs
genes.fpkm_tracking: Gene FPKMs.  同じgene_idを持つトランスクリプトのFPKMの積算
(cds.fpkm_tracking: Coding sequence FPKMs.)
(tss_groups.fpkm_tracking: Primary transcript FPKMs)

2) Differential expression 結果ファイル:  各cuffdiffランごとに4ファイル
isoform_exp.diff: Transcript differential FPKM.
gene_exp.diff: Gene differential FPKM.
(tss_group_exp.diff: Primary transcript differential FPKM)
(cds_exp.diff: Coding sequence differential FPKM)
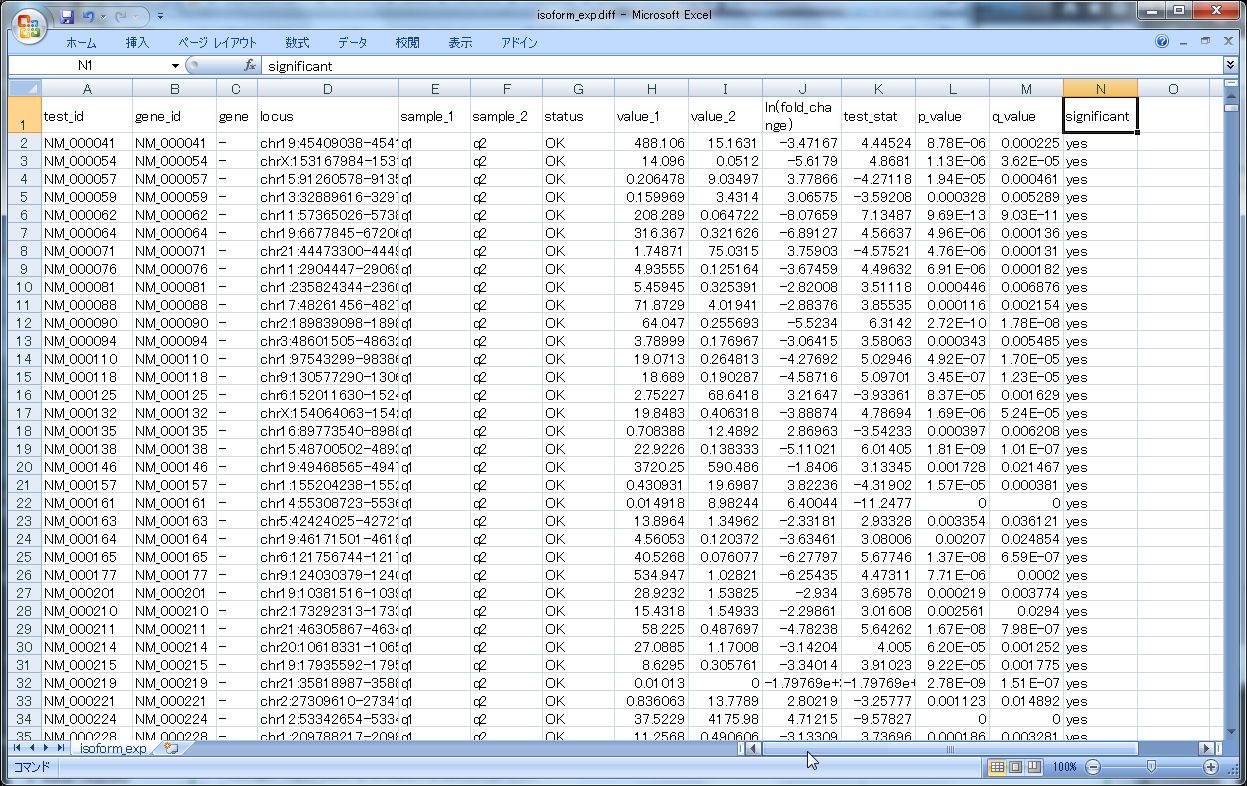
このうち、発現変動の結果ファイル、isoform_exp.diff をExcelで開いてみるとこんな感じです。
トランスクリプトのIDや名前、ポジション情報が先ずあり、そのあとHカラムくらいから、実際のカウンティングデータがきます。
  • FPKMx: FPKM of the gene in sample x
  • FPKMy: FPKM of the gene in sample y
  • ln(FPKMy/FPKMx):The natural log (自然対数) of the fold change y/x
  • test stat: FPKMの変動が有意であるかどうかの統計量
  • p value: 補正無しの p-value
  • q value: FDR-adjusted p-value
  • significant:"yes" or "no" マルチサンプル比較の場合はBenjamini-Hochberg補正後、FDR-adjusted p-valueが、cuffdiffランのパラメータ --FDR (デフォルト:0.05)より小さい場合は、"Yes" 有意だとされる
Ratioは、自然対数のログ表記という点にご注意ください。
また、Excelはsignificant = Yes で絞り込んでいます。

こんな風にして、RNA-Seq の実験データから、発現変動の有意な遺伝子を解析することができるのです。 
実際は、パラメータの調整などが必要ですが、感じはわかって頂けたと思います。

このあと考えられる操作は、
  1. 発現変動の有意だった遺伝子のポジション情報からBedファイルを作り、
  2. 先ほどソート済みのBAMファイルをGenome Viewerと一緒にとりこみ、
  3. ゲノム上で発現の変動と、マッピングの様子を同時に見る
ことでしょうか。 これはまた、Viewerに関する書き込みのときに詳しく説明します。

つづく


2011年6月2日木曜日

発現解析パイプラインを作るぞ! その1: TopHat の使い方

TopHatといえば、NGS発現解析で良く使われるツールです。
論文やポスターでも頻繁に見かけるので、一応、スタンダードなツールと見て良いでしょう。
TopHatと一緒にCufflinksという名前も、聞いたことがあるのではないでしょうか?
こちら、セットで使うと、RNA-Seqの解析にそこそこ威力を発揮します。

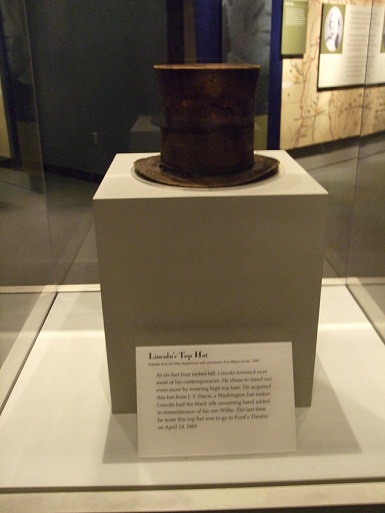
ちなみにこの写真は、エイブラハム・リンカーンが、実際に使っていたTopHatです。
スミソニアンのアメリカ史博物館での一枚です。
残念ながらCufflinks(カフスボタン)は、飾っていませんでした。
冗談はさておき、TopHatは、Exon-Intronのジャンクションを挟んでうまくアライメントするマッピングツールです。 Cufflinksは、そのマップされたフラグメント(リード)をカウントするツールです。
Cufflinksはこちらから(http://cufflinks.cbcb.umd.edu/)
ダウンロードできます。 マニュアルもあります。 Cufflinksは最近頻繁にバージョンアップされています。
TopHatを使うには、Bowtie(高速マッピングツール、http://bowtie-bio.sourceforge.net/index.shtml)
と、Samtools (SAM<->BAMファイルの変換やSNP検出などをするツール、http://samtools.sourceforge.net/)も一緒にインストールしておくと便利です。

Bowtie、TopHat、Samtoolsは、インストールも比較的難なくできますが、Cufflinksはちょっと準備が必要(bjamとかいうエンジンを入れる必要)ですので、行き詰ったらLinuxに詳しい方に助けを乞いましょう。 

4つともうまく入ったら、どんな風に動くのか、早速試してみましょう。
デモデータは、SRAから落としてきたSRP003186のデータを使います。 乳がんサンプル、イルミナGAIIのペアエンドデータです。
そうそう、SRAのファイルは、そのままでは解凍できないので、SRAのサイトからSRA-TOOLSというものを落としてきて、Linuxマシンにインストールします。 詳しくは昨年12月の書き込み(サンプルデータの取得法 2 NCBI 、http://shortreadbrothers.blogspot.com/2010/12/ncbi.html)にあるが、ここでのコマンドはfastq-dump2 から現在 fastq-dump に変わっているので注意!


全体の流れを示します。既知トランスクリプトーム情報を使った、発現変動解析パイプラインの大まかな例です。 必要以外のジョブもありますが、そこはつっこまないで。
  1. リファレンス配列Hg19を用意する
  2. Hg19に対してBowtieのインデックスを貼る
  3. TopHatを実行、リファレンスにマッピングする
  4. できたBAMファイルをソートしておく
  5. 後でViewerで見やすいようにソート後のBAMファイルにインデックスを貼る
  6. ついでにソートしたBAMファイルをSAMファイルにもしておく
  7. そのまたついでにソートしたBAMファイルをもとに、リファレンス配列と比較して異なる塩基(変異)のポジションを見つける
  8. さっき4でソートしたBAMファイルから、既知トランスクリプトのGTFファイルをもとに発現比較する ― Cuffdiff 実行
さて、リファレンス配列は、UCSCのFTPから適当なfa.gzをダウンロードしてきて、展開。
24本の染色体だったら、24個のファイルができるので、それを cat *.fa > hg19.fa としてひとつのファイルにまとめる。
ついでに、UCSCから、好きなアノテーションファイル(GTFフォーマット)を落としてきます。
これについては、この画面を参照 

  
インデックスは、Bowtieのbuildコマンドで
bowtie-build /Path_to_reference/UCSC_hg19/hg19.fa ./bowtie_ref/hg19

いよいよTopHatの実行です。
先ほどのgtfファイルを用意して、以下のようなコマンドを流します。 3つのサンプルがあります。
コマンドは3行です。ペアエンドなので、それぞれ***_1.fastq ***_2.fastq というファイル名です。

tophat -r 100 -p 4 -G /Path_to_gtf/refGene.gtf -o ./tophat_SRP003186_Control /Path_to_bowtie_ref/hg19 /Path_to_read_file/Control/SRR064437_1.fastq /Path_to_read_file/Control/SRR064437_2.fastq
tophat -r 0 -p 4 -G /Path_to_gtf/refGene.gtf -o ./tophat_SRP003186_MCF7/Path_to_bowtie_ref/hg19 /Path_to_read_file/MCF_7/SRR064286_1.fastq /Path_to_read_file/MCF_7/SRR064286_2.fastq
tophat -r 100 -p 4 -G /Path_to_gtf/refGene.gtf -o ./tophat_SRP003186_SKBR3 /Path_to_bowtie_ref/hg19 /Path_to_read_file/SK_BR_3/SRR064441_1.fastq /Path_to_read_file/SK_BR_3/SRR064441_2.fastq

パラメータについて
-r:  inner mate distance 平均フラグメントの長さ-両側のリードの長さ。MCFの例の場合、フラグメント長は100塩基でリード長は50塩基なので、100-50x2=0
-p: 使用するCUP数(デフォルト:1)
-o: アウトプットファイルを書き出すディレクトリ
-G: gtfファイルの場所
このほかのパラメータについてはおいおい。 もちろんTopHatのウェブサイトにも情報はたくさんあります。

アウトプットファイルは、たくさんできるのですが、以下の3ファイルがとくに重要!というか、後はあまり見ません。
  1. accepted_hits.bam:BAM フォーマットのアライメントファイル
  2. junctions.bed:Exon Junction情報をまとめたファイルで、UCSC BED track フォーマット。ジャンクションは2つのBEDブロックから成り、"maximal overhang" で指定した数以上の塩基によって構成しているはず。スコアはアライメントの数を示す。UCSC ゲノムブラウザに表示できる
  3. insertions.bed / deletions.bed:insertions/deletions情報をまとめたUCSC BED tracksファイル。
    Insertions.bed の chromLeft は、Insertion直前の塩基を表し、
    Deletions.bed の chromLeft は、Deletionする最初の塩基を表している、らしい
 さて、ここまでいかがでしょうか?

つづく

2011年2月23日水曜日

ChIP-Seqで量的解析は可能か

SEQanswers で面白いトピックがあったので紹介します。
ChIP-Seqをやったとき、例えばChIPを2つの異なるセルタイプで行って、マッピング後、FindPeaks等のPeak Detectionソフトを使ってそれぞれPeakを検出したとします。
InPutも2つのセルサンプルに対して使用しています。 
結果、2つのサンプル(AとB)に対してそれぞれ、Peakがたくさんある状態です。

さて、サンプルAでは、ゲノムのある場所で、100リードからなるPeakが検出されました。
サンプルBも、Aとまったく同じゲノムの場所に、200リードからなるPeakが検出されました。
FDR、p-value等の条件は、ほぼ同じです。
このとき、サンプルBのこの場所は、サンプルAより2倍、タンパク質がDNAに結合しやすい、と言えるでしょうか?

テストの問題にいいですね。

ちょっと考えてみましょう。

リードの本数は、タンパク質の結合しやすさに関係するのでしょうか?

そもそもリードの本数は、実験によって異なります。
RNA-Seqの場合、発現量を計算するとき、実験で得たリード本数全体を考慮してノーマライズする方法があります。 マイクロアレイでも発現値をグローバルノーマライズやMedianノーマライズをしますよね。 全体の発現量が大きいアレイと、小さいアレイとを、同等に比較するためです。 テクニカルな、実験的なアーティファクトを除去するのです。

話を戻すと、出力されるリードの本数の総数は、サンプルAとサンプルBで異なるはずです。
もし、サンプルAからは1000万本のリードが出力され、サンプルBでは4000万本のリードが出力されていたとします。極端な例ですが。
では、ゲノムの同じポジションで検出されたPeakを構成するリードの本数、A: 100本、B: 200本に、どれだけの差があるでしょうか。
Bのほうが、このPeakあたりのリードの本数率(というのをあえて計算するならば)は低くなりますね。
A: 100/1000万、B: 200/4000万

実はこれはナンセンス、だと思います。
だって、検出されるPeakの数は普通、同じじゃないから。

この実験で用いたタンパク質は、サンプルAではゲノムの1000箇所に結合し、サンプルBでは2000箇所に結合したとします。
実験で得たリードの総本数は1000万本で同じとしましょう。
ほかの条件も同じと仮定すると、Aの1Peakあたりのリード本数は、Bの1Peakあたりのリード本数より、多くて普通と想像できませんか?

では、このタンパク質が、サンプルAでゲノムの1000箇所に結合し、同じくサンプルBでも1000箇所に結合した、とします。
その1000箇所がまったく同じであることはまず無いでしょうが、500くらいは同じ場所に結合するかもしれません。
リードの総本数も、ABともにほぼ1000万本で同じとします。
さて、この場合、500の箇所に関しては、Peak構成リードの本数で比較ができそうです。

Aの500箇所は平均100本のリードによってPeakが作られている。
Bの500箇所は平均200本のリードによってPeakが作られている。
よって、Bのサンプルでは、Aより2倍、タンパクが結合しやすい。

うーむ・・・。
なんかしっくりきません。

500箇所全部ではなく個別で見ても同じでしょう。
500箇所のある場所 A:100リード、B: 200リード (Bが2倍結合しやすい)
また別のある場所 A: 200リード、B: 50リード  (Aが4倍結合しやすい) … 続く
こんな風に、Binding箇所を個別に見て、AとBのリード数を比較してタンパク質の結合のしやすさを判断することが可能でしょうか?

いいえ。共通する500以外の、共通しない500のPeakを考慮していません。どれだけの本数のリードが、共通しない500Peakに使われているでしょうか。

私が知る限り、現在のChIP-SeqのPeak検出アルゴリズムでは、異なるサンプル間のタンパク結合のしやすさを評価することはできません。
少なくとも、今のアルゴリズムで検出されたPeakを、リードの本数をもとに比較することはできないと思います。
近い将来、2つ以上のサンプルで検出したChIP-Peakから、何らかの量的解析をするアルゴリズムが出てくるかもしれませんね。

2011年2月9日水曜日

ChIP-Seq、RNA-Seqの良いレビュー

私がこのNext-Genの配列解析を本格的に始めてもうすぐ1年になります。
それまでは主に情報収集で、各種シーケンサーメーカーのセミナーに出席したり、PubMedで文献を探しては読んだり、ネット上の掲示板を参照したりしていました。

解析ツールを使って、実際のデータや、SRAからダウンロードしたデータを流していると、ふと、自分のやっている方法が正しいのか、他のひとはどうやっているのか、考えてしまいます。
どのツールを選ぶか、は最も重要な問題だと思います。 
そんな中、このレビューは良くまとめられています。
Computation for ChIP-Seq and RNA-Seq studies. Pepke et al. (2009) Nature Methods v.6 S22

ChIP-Seq, RNA-Seqの解析方法から良く説明されており、初めての方はこの文献を読まれることをお勧めします。

もうひとつ、私がすきなレビューは、こちらです。
Statistical Issues in the Analysis of ChIP-Seq and RNA-Seq Data. Ghosh et al. (2010)Genes v.1 p317
バイオロジカルな視点からChIP/RNA-Seqの限界や、解析方法の問題点なども述べられています。
勉強になります。
RNA-Seqなどの結果の解釈の前に、一度読まれることをお勧めします。