ラベル NGS解析ソフト の投稿を表示しています。 すべての投稿を表示

2017年11月4日土曜日

DRAGEN 名実共に世界最速のNGSサーバに! ギネスブックに載ったぜい!

今気付いたんですが、このブログの前回の記事が昨年のASHGだったんですね。
それもEdicogeonme社、DRAGENの話。
偶然ですが今回の記事もASHG、それもDRAGENの話!


ついに、ギネスブックに載ったぜ!

このニュースはすごいと思いません?
真ん中にいるジャケット来たかたがギネスのおっさんです。

どういうことでギネスに載ったのか、というと、1000人分のヒトゲノムを最高スピードで解析するシステム、ということらしいです。
私もちゃっかり記念撮影

Edicoの夜のパーティにはたくさんひとが集まり、盛り上がりました。
昨年はバンクーバーで、今年はオーランド。
バンドの生演奏やもちろんタダ飯&タダビール。もちろんプレゼンもこんな感じに、真面目にやってました。


さて、Edicogenome社のホームページに行ったかたは気づいたかも知れませんが、Dragenがクラウドサービスを始めました。
具体的にはDNA Nexusのパイプラインを使っていて、DNA NexusはAWSを使っている、というわけですが、現在はアメリカだけのサービスです。
残念ながら、AWSとの大人の事情で、日本ではクラウドサービスの予定は未定なんです。

というわけで日本ではハードウェアがありますのでどうぞ宜しくお願いします!

このギネスの話を拡散したら、問い合わせがあちこちから来ました。
日本のクリニカルシークエンスにも、Dragenサーバが使われる日も近い、かな。


2016年3月6日日曜日

DRAGENサーバ とりあえず動かしてみた(1)

この間、秋葉原で「第二回PacBio現場の会」という、PacBio Specificのセミナーをやりました。
その中で余興として、例の超高速NGSサーバ「DRAGEN」のデモをやるはずでした・・・。

まあ、いろいろあって、23日には間に合わなくて、うちの同僚Dにはプレゼンで乗り切ってもらいましたが。

そんな中、ついに、先週我がオフィスに到着したDRAGEN君。
オフィスについて早速ケースを脱がされ、裸のハードを横から見られているDragen君。かわいそうなので写真は前から

同僚Dは早速セットアップ、ヒトゲノムリファレンスを入れて、ハッシュテーブルを作って、HiSeq2000のサンプルデータを流してくれた。
20Xの全ゲノムシークエンスデータ。

パイプラインは、
  1. fastqのgzを入力データに
  2. リファレンスマッピング
  3. Bamファイルを書き出して
  4. Variant Callingして
  5. VCFを出力
という至ってベーシックなもの


で、速さなんですが、

笑ってしまうくらい速い!

Time loading reference:              00:00:00.000
Time aligning reads:                 00:07:06.006
Time sorting and marking duplicates: 00:09:37.107
Time saving map/align output:        00:09:43.040
Time partial reconfiguration:        00:00:06.019
Time variant calling:                00:09:51.977
Total runtime:                       00:17:13.450

20カバレッジヒトゲノムのマッピングからSNPコールまでが17分?
もう一度、今度は私が別のデータ(同じく約20X)でトライ

Time loading reference:              00:00:20.827
Time aligning reads:                 00:06:59.932
Time sorting and marking duplicates: 00:09:01.473
Time saving map/align output:        00:09:06.573
Time partial reconfiguration:        00:00:05.873
Time variant calling:                00:09:17.615
Total runtime:                       00:16:59.875

えっ、17分?速っ!
20Xの全ゲノムマッピングですよ!

何でこんなに速いのかは、FPGA使ってます、以外に正直説明できないのですが、とにかく速いのは確かです。

コマンドラインなんで、デモをやったとしても、はっきり言って、地味です。
ターミナル眺めているだけになるので、これなら「現場の会」で見せるとしても工夫が必要だったなーと、いまさらながら思います。


今日は、「とりあえず動かしてみたら、やっぱり速かった」という報告です。
本当はもっと大きなデータ、それもBCLから試すべきでしたけれども、手元にBCLが無かったので断念。
BCL→fastq変換も、確か10分程度で終わるはずです。
これもすごい速いですよね!!

まあ今回は、fastq.gzからの入力でも十分速いことが実感できたのでこれで良しとします。
次回は、BCLからの変換速度、いくつか解析メニューの紹介、になるかな。


というわけで皆さん、DRAGENに興味があるならば、もう日本でトライアル可能です!

一番簡単なのは、ハードディスクでHiSeqのデータを送ってもらうことでしょうか。
オフィスに到着したら、DRAGENサーバにコピーして、解析します。
(もしお客さんが解析の様子を実感したければ、ウェブミーティングなどで生中継することも可能かな?)
そして結果とログファイルを全部お返しする。という流れ。
興味がある方は、こちらからカタログ請求の下の備考欄に、「DRAGENトライアルしたい!」と書いて送ればOK!
「このサーバ、いくらですか?」 という質問にも、丁寧にお答えします。

データを外に出せない!という方は、その旨書いてくれれば、サーバ本体を貸し出すことも条件付きですが可能です。


2016年1月26日火曜日

Biomatters ニュージーランドのNGS解析ソフト会社 安くても高機能

私のことを個人的に知っている方なら、以前、NGS解析ソフトといえばCLC-Bio!みたいなことを言っていたのをご存知でしょう。

CLC-BioのGenomics Workbenchは確かに、良くできたソフトです。
NGS解析ひと通りのことはできる。
マルチプルアライメントやBLASTなど、普通の配列解析もできる。
プラグインを使えば(有償、無償いろいろある)、解析の幅も広がる。
サポートをやっていたので贔屓にしていましたが、お客さんから言われた欠点らしきものといえば、価格が高いこと。
確かアカデミックで、70万円以上+年間アップデート費

限られた研究費で、実験にお金をかけるのはともかく、ソフトウェアにはできればあまりお金をかけたく無い、というのも良く耳にしました。
だから無料トライアル期間を利用して解析を一気にやってしまおう!という考えの方もいらっしゃった。
その気持ち、わかります。

でも、もっと安いソフトがあれば、使用制限無しに使い倒せば良い。

CLC-Bio社の創設者がかつてオックスフォード大学に在籍していたとき、同じ大学のもうひとりの研究者も、配列解析のソフト会社を作りたいと考えていました。
そして、ひとりはデンマークでCLC-Bio社を立ち上げ、もうひとりはニュージーランドでBiomatters社を作った。
お互い、配列解析ソフトウェア専門の会社。
コンセプトは若干違うものの、ふたりとも、「バイオインフォマティシャンではないウェット研究者でも使えるソフトウェア」を、世界中に普及させた。

日本でCLC(現キアゲン)の方が知名度が高かったのは、いち早く代理店制を取り入れたから。私も結構あちこちで宣伝しました。ええ。

Biomattersは遅れながらも昨年ようやく、トミーデジタルバイオロジー(株)と代理店契約を結んだ。
ということで私のPCには現在、BiomattersのNGSソフトウェア「Geneious」が入っています。
正直、使いやすさは良いです。
一般的な配列解析(NGS以外)は一通り揃っています。
NGS関連だと、アセンブリ、マッピング、変異解析、16S解析(パイチャート作成まで)、などなどはOKです。
ChIP-Seqはできない。

GUIはまあまあ。すごくかっこ良いというわけでは無いけれど、ダサくも無いかな。
一番の売りは、低価格ということと、無料のプラグインが多いこと。

低価格というのは、他のソフトと比べて、という条件付き。
ざっくり、Genomics Workbenchの半額以下です。

あとは、3月25日まで、2本買うと1本無料で付いてくるキャンペーンやってます(アカデミック価格で税抜き)。
ソフトウェア3本買って30万円未満!
ということは1本10万円!
ね、安いでしょ。これならもう、トライアル期間で解析しちゃえ!なんて思わないでしょ?(笑)
もちろん、トライアル期間も無くは無いです。


このソフトは買取りです。
2年目からは、アップデートフィーがかかります。

さらに、もしあなたが学生さんなら、1本、78,840円で買うこともできます!
安いでしょ? 詳しくはこちら下のほうをチェック。

安くても、機能はかなり充実しているソフトウェアです。それは保証します。
世界のシェアも実は1位かもしれない。ですよ。


こちらのイベント、「第二回PacBio現場の会」もよろしく
Geneiousの質問もあればこのときにどうぞ

2015年9月8日火曜日

超高速でNGS解析 DRAGEN(2)

DRAGENという製品は、アメリカ・サンディエゴに本社を置く、Edico Genome Inc.という会社が開発しました。
この会社、2014年のThe Scientist Top 10 Innovations の1位に輝いたベンチャーです。


DRAGENサーバの速さの秘密は、FPGAにあります。
ん? なんのこっちゃ?

FPGAとは、field-programmable gate array
直訳すると、「現場でプログラム書き換えできる集積回路」
「現場」って何?
簡単に言うと、「後でハードウェアを書き換えることが可能な集積回路」

ICやLSI(大規模集積回路)は後で書き換えができない集積回路ですが、一般に半導体というとこれらを連想する方が多いのではないでしょうか?
私も小学生の頃、欲しかったパソコン(結局高価すぎて買えませんでしたが)の雑誌を読んでいて、ICとかLSIとかの名前を知った記憶があります。
トランジスタがたくさん集まって小型化したのがIC、さらにたくさんのIC回路を集積して、高度な計算に使用されるのがLSI、そんな説明だったと思います。
配線が固定なのは当たり前なので、後で回路をプログラムで書き換えることができるチップがあるなんて、知らなかった、というかたもいるでしょう。

LSIなどとは別に、ハードを作った後に、回路を自由に書き換えできるのがFPGAです。
歴史的には1970年代からPLD(Programmable Logic Device)というものがあったそうで、主に製品開発途中で回路を書き換えするのに広く使われていたそうです。
今では、製品を出荷した後でも、回路の書き換え(バージョンアップなど)ができるように、書き換え可能な集積回路が多く使われているとのこと。
このサイトに歴史から原理・応用まで詳しく説明されています。 
開発者向けではありますが、こういうサイトもFPGAに詳しいです。

私はこの辺、全然素人なので、FPGAについてはこれくらいにしておきます。
ま、要するに、DRAGENサーバとは、「FPGAを使ってNGS解析専用に回路を書き換え、また後で書き換えも可能にした大規模集積回路と、専用に作られたソフトウェアが乗っかった、NGS解析サーバ」
です。


EdicoGenome社が提供するDRAGENボード
これがDRAGENボードです。

真ん中にあるDRAGENと書かれたプロセッサが、書き換え可能なFPGAプロセッサ。
両サイドにある4枚のメモリに、リファレンス配列をハッシュ化して記憶します。
プログラムがハードウェアに直接書かれているので、通常9時間かかる解析が、たった20分で終わる、というふうに超高速に解析を行なうことができるのです。

ゲノムパイプライン(リシークエンス&変異解析)の場合、マッピングはbwaと同じ、smith-watermanアルゴリズムを使用、変異解析はGATK-HCと同じ、隠れマルコフモデルを使用。
詳細は間もなく論文で明らかになるはずです。

海外では既に実績があります。
例として、
  • Children’s Mercy Hospital of Kansas City;遺伝病を抱えて生まれてきた赤ちゃんのゲノム診断には、スピードと精度が必要。DRAGENサーバにより、これまでの解析パイプラインと比べて飛躍的に速く、そして正確にタイピングすることができるようになった。 このお話は、来月のアメリカ人類遺伝学会の、Edico Genome社のセミナーにて聞けますよ。 もちろん私も聞いてきます!
  • CDC(Centers for Disease Control and Prevention)では、Edico Genome社との共同研究を通じて、微生物ゲノムの研究に使用されているそうです。また、
  • PerkinElmer社のNGS解析パイプラインに採用されたり(この記事参照)、
  • Harvard大学やStanford大学では、300カバレッジのヒトリシークエンス解析を10分の1の時間(60時間→6時間)で完了したり(このニュース参照)、
と、まだこれからですが、ゲノムシークエンスの解析の分野で、久々にすごい技術革新が登場したという印象があります。

興味ありませんか?


解析サーバは前回のブログ記事のスペックです。
このサーバでMiSeqからHiSeqXまで対応できるとのこと。こちらのサーバは買取り。
これにボードが付いてきて、ボードは年間レンタル。
解析するデータ量に従って課金されるランクが変わるシステムです。
携帯電話みたいな感じですね。 一応、「パケ放題」も対応してますがX10システムでもない限り必要ないでしょう。

興味ありませんか?

無料トライアルもできます。
データを送って、解析結果を返却、のような流れです。
これでは速さが実感できませんが、タイムスタンプを信じて下さいね。

もう一度、

興味ありませんか?(しつこい)

価格とかトライアルとかについて知りたい! という方は是非、ご連絡下さい。
まだ弊社のホームページは準備されていないので、私宛のメール宛てにお願いします。

ken_osakiあdigital-biology.co.jp 「あ」を@に変えて下さい

gmail, hotmail 以外のメーラーで送って下さいね。
ホームページ準備されたらそのリンクに書き換えます。

もちろんこのブログにコメントでもOKです。

アメリカ人類遺伝学会の後に、もっと情報アップデートできると思います。
楽しみにしていてください!

2015年9月7日月曜日

超高速でNGS解析 DRAGEN(1)

NGS解析で一番困っていることは何ですか?
データの量が多すぎ? 解析サーバが非力? ゆえに結果が出るまでのスピードが遅い?
良く引き合いに出される、「ムーアの法則以上に、NGSのスループット革新は速い」というのは、解析するほうにとっては頭の痛い問題。

じゃあどうするか?
仕方が無いので解析サーバを増強したり、スパコン借りたり(操作できるひとは限られるでしょうが)、外注に出したり。
でもやっぱり行き着くところは、大量のデータ解析をするには、それなりの計算サーバが必要だということ。
日本にも、ライフサイエンス関連でいうと、何社かありますよね、NGS解析環境を作ってくれるサーバ屋さん。学会展示会場で良く見かけます。
彼らに共通するのは、汎用サーバを、NGS解析用に適した環境にカスタマイズしてくれるということ。
汎用サーバの中にNGS解析ソフトウェアをインストールして、メモリをうんと積んだり、ディスクをいいもの使ったり、I/Oを速くしたりしていると思います。
なので、同じソフトウェアを使っている限り、劇的にスピードがアップするということは無い。

でも、もし、ハードウェアからNGS解析用にチューニング・設計して、それに合ったソフトウェアを乗っけたNGS専用サーバがあったらどうでしょう?

あるんです!


今年(2015年)の「NGS現場の会・つくば大会」で、私の発表を聞いた方はご存知かもしれませんが、すごいNGS解析サーバが日本にやってきました。

その名も DRAGEN: Dynamic Read Analysis for GENomics

これが超速解析サーバなんです。
例えばショートリードでヒト全ゲノムをリシークエンスして変異解析をするとき、基本的に以下の順序で行います。
  1. BCL→FASTQ変換
  2. FASTQクオリティフィルタリング
  3. リファレンスマッピング(BWA)
  4. マッピングポジションをソーティング
  5. ダブっているマッピングを除去(リピート部分など)
  6. BAMファイル圧縮出力
  7. バリアント検出(GATK)
  8. VCFファイルの出力
このパイプラインを、ヒトゲノム30xのデータで行なった場合、皆さん、どれくらいの時間で終了していますか?

サンプルデータはSRA056922(NA12878の、全ゲノムリシークエンス)
101bpのペアエンドリード(平均距離410bp ± 14bp)が10億8000万本(ヒトゲノム30カバレッジ)
これを、
CPU: Intel Xeon E5-2697v2、2.7GHz、12コア
Memory: 128GB

Disk Controller: 6 GB/s; Support for JBOD (pass through); Support for TRIM commands
Stagind Disk: 8 x 400 GB RAID-0 SSD (High Endurance Intel SSDs)
OS Disk: 2 x 120GBSSD in HW RAID 1 configuration
のサーバ
ふつーのワークステーションサイズ
で、やったとします。
BWA-MEM 0.7.9a/GATK-HC 3.1.1でデフォルトで解析したとき、BCLからVCFまで、かかった時間は約9時間
同じ解析を、DRAGEN Genome Pipeline 1.3 でランすると、何と、20分弱で終了!

9時間が20分ですよ。すごいでしょ。
説明を追加

速く解析が終わるということは、精度を犠牲にしているのでは?

いえいえ、そんなことはありません。
以下のテーブルを見て下さい。

真陽性はBWAパイプラインとほとんど変わらず。
擬陽性はDRAGENの方が勝っています。
SNPのROCカーブも、BWA-GATK、DRAGEN共にほとんど変わりません。

DRAGENパイプラインは、マッパーやバリアントコーラーに、独自のものを使っています。
BWAと全く同じでは無いですが、原理は同じようなものだそうです。
バリアントコーラーも、HMMを用いた検出アルゴリズムを使っています。
まもなく論文にそのあたりが明らかになる予定です。

でも、なんでそんなに速いのでしょう?
その秘密は次回のお楽しみ


2015年9月5日土曜日

久しぶりにこちらも更新!

ご無沙汰しています!
最後に「ショートリードの憂鬱」を更新したのが2012年なので、もうすぐ4年になりますか。
4年前まであんなにショートカットの彼女に想いを寄せていたのに、急にロングヘアの彼女に浮気して、気がついたらやっぱり昔のショート彼女も、手がかかったけど良かったなあ、って戻ってきた感じでしょうか。
あー、例え悪いですね。女子からは引かれそう。

冗談はそのくらいにして、もちろん最近までロングリードに夢中になっていたのですが、やっぱり気になっていたというか、最近はクリニカルシークエンスなどが熱いですよね。
これはやっぱり現在はショートリードの独壇場。
もちろんロングも頑張っていますが、もう少し時間がかかるかな。

で、「憂鬱」だった4年前のショートリード解析も、今やどんどん進化して、「快適」とまでは言わないまでも、「たまに若干憂鬱」くらいにはなってきたんでは無いでしょうか?
いやいや、まだすごい大変だよ!
という声が聞こえてきそうですが、その大変さというのも、4年前とはレベルが違うでしょう。

NGSが一般のライフサイエンスの現場に浸透していくにつれ、必ずしもインフォマティシャンではない研究者でも扱える機器になりました。
どんな分野でもそうですが、最先端の研究・誰もやったことの無い研究、パイオニア的な研究者は自分でツールを作らないといけません。
技術が汎用的になって、ある程度原理を理解した研究者が自分の研究にその技術を応用しようとするときは、優れた汎用ソフトウェアが必要になります。
汎用ソフトウェアでは自分のやりたいことができない、あるいは自分で解析する時間が無い、というかたは、受託解析を外注するでしょう。

私もかつて前職で、ちょうどNGSが日本に広まりつつある時期、汎用ソフトウェアを売ってサポートしていたり、受託解析サービスをしていました。
お客さんが100人いれば、100通りの質問、要望をします。
大変でしたが、本当に革命的な技術が広がるときの、ダイナミックな動きを肌で実感することができました。

今も、よりメーカーサイドに身を置きましたが、刺激的なのは変わりません。
むしろ、ロングリードの質問は、ショート側にいたときからは想像がつかないもの。
海外に出張すると、日本にはまだ入ってきていないビジネスや技術と触れることも多いです。
カリフォルニアという場所柄、競合企業にいたひとが会社を離れて新しいビジネスを始める、なんて普通。
ひとの動きは日本とは比べ物にならないですからねえ。


さて、しばらくロングヘアの彼女に浮気していたわけですが、この業界にいると、ショートヘア彼女の周りが騒がしくなっているのがよーくわかるのです。
ショートヘア彼女はモテるんですよ。
いろんな奴が周りにいる。
私もそんな状態を放っておくわけがない!

と、いうわけで、ショートリードについてのネタ、ちょっと紹介します。

  1. NGS解析を超高速にするサーバ「DRAGEN」について
  2. クラウドでの解析「DNAnexus」「iOMICs」について
  3. SalesForceを使ったLIMS「Third Wave Analytics」について
  4. そのほか、クリニカルシークエンス について
お楽しみに!


2011年9月10日土曜日

NGSでmicroRNA 2

前回はNGSでmicroRNAを読むときの一般的なワークフローで、マッピングまで書きました。

既知のmiRNA配列にマップしたときは、その発現量がマップされたリードの本数で表現できる、ということは直感的にわかるでしょう。
以前、RNA-Seqの発現量推定のところでも書きましたが、リードの数はサンプルごとのノーマライズ(正規化)が必要です。

(その既知miRNAにマップされたリードの本数)/ (そのサンプルランで取れた全リードのうちmiRNAにマップされたリードの合計数)

出力されたリードの数、特にマッパブル(Mappabl)なリードの総数は、サンプルによって異なります。 ですから、各miRNAにマップされたリードの本数を全体で割ってあげて、異なるサンプル間で比較可能にするのです。
分母を、そのサンプルのリード本数全体 として計算している方もおられますが、私は、マップされたリード本数全体 とした方が精度が上がると考えています。
だってマップされないリードまでノーマライズの分母に含めるのは不自然でしょう。

これだけでは値が非常に小さくなるので、100万倍して、RPM(Read Per Million)という表現にするのが良いかも知れません。

さて、そうして正規化された値は、当然ながらmiRNAの発現量そのものではありません。
あくまで比です。
ということで、この値は、ほかのサンプルの正規化miRNA発現値と比較して、何倍発現量が多い、少ない、というような解析に持っていきます。
マイクロアレイと同じですね。

Nが3以上あれば、正規化後の値を対数変換してから、通常の統計手法(T‐Testなど)で比較すると良いでしょう。

DESeqという発現量比較のツールも使えるかと思います。
いろいろ調べてみると結構miRNA関連論文で、このDESeqが使われています。 
元々は発現変動遺伝子を解析するツールです。 
遺伝子は全部で数万あり、その中でほとんどは変動していない、という仮定の下、変動有意遺伝子を見つけるわけです。
microRNAは全部でもたかだか数百、これで遺伝子発現と同じモデル(負の二項分布)式を使っても良いのか、という疑問は残りますが、ここではそれを置いておくとして。

Nが1しか無い場合、割り算して比較するしかありませんね。

有意な発現変動を示したmiRNAが見つかったら、そのターゲット遺伝子を探してみましょうか。
データベースとしてはまず、miRBase (http://www.mirbase.org)がいいでしょう。
ここからはTargetScan Pictar といった、ターゲット予測プログラムのサイトへもリンクできます。
ターゲット遺伝子を見つけたら、その遺伝子のGO(Gene Ontology)を検索して、どんな機能の遺伝子がターゲットになっていたのか、を調べることも良く行われます。

さて、これら以外に、NGSならではの解析とは何でしょう?

そう、既知ではなく、未知のmiRNAを見つけることです。

それには先ず、マッピングのデータから、既知miRNA以外の場所にマップしたリードが作っている、ある程度の長さのクラスターを見つけてこなければいけません。
ある程度の長さって、どれくらいだ?
クラスター配列は、2次構造を取り得る、いわゆるpalindromicの配列でなくてはなりません。
1次元で言うと、(mature miRNA配列)+(ループ構造)+(mature* miRNA配列)のパターンである必要があります。
そのような配列を取ってきたら、エネルギーが最小になるようなときにちゃんとヘアピンのようにフォールドするかどうか、を確かめます。
さらに、Droshaなどのタンパク質に切断されるサイトがあるか、調べます。

これを全部プログラムを作って行うのは大変ですが、幸い、アカデミックの方ならフリーで使えるツールがあります。 miRDeep というものです。


このドラえもんの手、みたいなのがmature miRNA-Loop-star の2次構造で、薄い線がマップされているリードです。 
matureの方により多くのリードがマップされているのは、より本物らしいmicroRNAだったことを裏付けます。

残念ながら、企業はフリーじゃないんですよね。 いくらか払うのかな。

2次構造だけの予測なら、できるソフトもありますが、miRDeep ほど特化しているものは少ないでしょう。 チャンスがあれば使ってみたいです。


microRNAをNGSで解析するというテーマで、よくまとめられているレビューがあるので紹介します。
Motameny et al. (2010) Next Generation Sequencing of miRNAs - Strategies, Resources and Methods. Genes. 1, 70.

こちらはmiRanalyzerというツールのワークフローです。フローは参考にしています。
Stark et al. (2010) Characterization of the Melanoma miRNAome by Deep Sequencing. PLoS One. 5, e9685.

発現量比較から新規miRNA予測、ターゲットのGO解析まで行った例です。 こちらも良い。
Dhahbi et al. (2011) Deep Sequencing Reveals Novel MicroRNAs and Regulation of MicroRNA Expression during Cell Senescence. PLoSOne. 6, e20509.

2011年8月27日土曜日

SIFT SNP機能予測アルゴリズム

今日もSNVの話です。
1塩基の変異が、タンパク質にどんな影響を与え得るのか、の予測アルゴリズムです。
今までPolyPhenとかGrantham Scoreとかについて少し触れましたが、今日はSIFTというアルゴリズム&ツールについて。

"SIFT" ってググると、上位には画像検出アルゴリズムがたくさん出てきますが、これは違うので必ず、"SIFT SNP" とかで検索して下さいね。 (画像検出の方も興味がありますが)
http://sift.jcvi.org/
SIFTとは、Sorting Intolerant From Tolerant の略です。
???
そもそもtolerant とは何でしょう?
辞書で引くと寛容な、とか耐性、とかがあります。 
ここではタンパク質の機能に変化が無い、ということを意味します。


SIFTの考え方の基本は、配列保存性です。
同じタンパクファミリーの中で、保存性の高いアミノ酸配列があったとします。 
そのような配列の中のアミノ酸変異・置換は、タンパク質の機能に致命的な影響を与える可能性が高いと思います。 
機能を失ったタンパク質は、進化の過程で生き残れませんね。

反対に、タンパク質機能に重要な影響を与えない部分のアミノ酸ならば、進化の途中でどんどん置換が起こり得るだろうし、またそのような機能に影響の無い場所のアミノ酸置換は、生き残っているタンパク質にも見られるはずでしょう。

つまり、配列の保存性が高い場所のアミノ酸置換は、タンパク質機能の変化という点でIntolerant(影響あり)。
配列保存性の低い場所のアミノ酸置換は、タンパク質機能変化にTolerant(影響なし)。

この方法は、正しいタンパク質ファミリー(オーソログタンパク)を集めてアライメントすることが重要です。その中で配列保存性を見ていくからです。 
UniprotやNCBIのnrなどから配列データを借りています。

さて、このように配列相同性のみを使用した予測ツールでは、タンパク質の立体構造までは見ていません。 
ループ構造部分に変異があるのか、疎水性が失われるのか、といった情報までは見ていないのです。
これらは別の予測ツール(Polyphenなど)が必要です。

NGSでSNVを見つけた。
Non-synonymousのSNVを絞り出した。
次に考えるのは、そのnsSNVの重要性です。
そのアミノ酸が変わったらタンパク質として生き残れないよ、という情報は、重要性の指標になります。
そのアミノ酸が変わっても、タンパク質は生き残っていたのなら、その置換はさほど重要ではないでしょう。
最初にSIFTなどで、配列保存性を基準にnsSNVの重要性をフィルターにかけ、残った重要そうなやつを、次にタンパク質立体構造上で確認していく方が近道のような気がします。

さて、実際にNGSでSNVを見つけてからこのツールを使って解析するにはどうしたら良いか?
先にURLを示した場所よりも、以下から入る方がお勧めです。
VCFフォーマットをSIFT専用のフォーマットにコンバートしてくれるからです。

http://sift.bii.a-star.edu.sg/www/SIFT_intersect_coding_submit.html
ここで、SAMtoolsなどで求めたVCFファイルをアップします。
そうするとしばらくして、コンバートされたファイルができますので、これをPCに保存します。
SNP用のファイルと、InDel用のファイルの2種類できます。
ここではSNP用ファイルを例に、落とします。
保存したら、upload here のリンクをクリックして、そのファイルをアップロードします。
その時、自分のE-mail アドレスと、オプションでどんなアノテーションを付けたいかを指定します。
結果は、HTML、またはテキストで参照できます。
これがSNPの結果
リンクできるところはそれぞれのDBにリンクしています。
HTMLだと、ちょっと扱いにくいので、私はテキスト(tsv)で落として、Excelで見ることもお勧めします。
例えば、こんな風に絞り込めば、新規っぽいSNPの機能を予測できます。

この絞り込みの条件は、
  1. dbSNPに登録の無い "novel" SNPで
  2. アミノ酸置換をもたらす Non-synonymous SNP
です。 ここで、SNP-Typeの右の、Predictionカラムでソートして、DAMAGING(=Intolerant)を選ぶのです。
その時、ScoreとMedian Infoにも注目します。
Scoreは0から1の値を取り、0.05以下のとき、タンパク質機能に影響あり(=Intolerant = Damaging)とされます。
Median Infoは保存性の信頼度で、0から4.32の値をとり、大きいほど信頼度が低くなります。 3.25以上のときはLow confidenceとして警告が出ます。

どうでしょう? SNPの機能を調べるにはとても使いやすいツールだと思います。


 もっと詳しく知りたい方は、

 http://sift.jcvi.org/www/SIFT_help.html

Kumar P et al. Predicting the effects of coding non-synonymous variants on protein function using the SIFT algorithm. Nature Protocols 4, 1073-82 (2009).

2011年8月20日土曜日

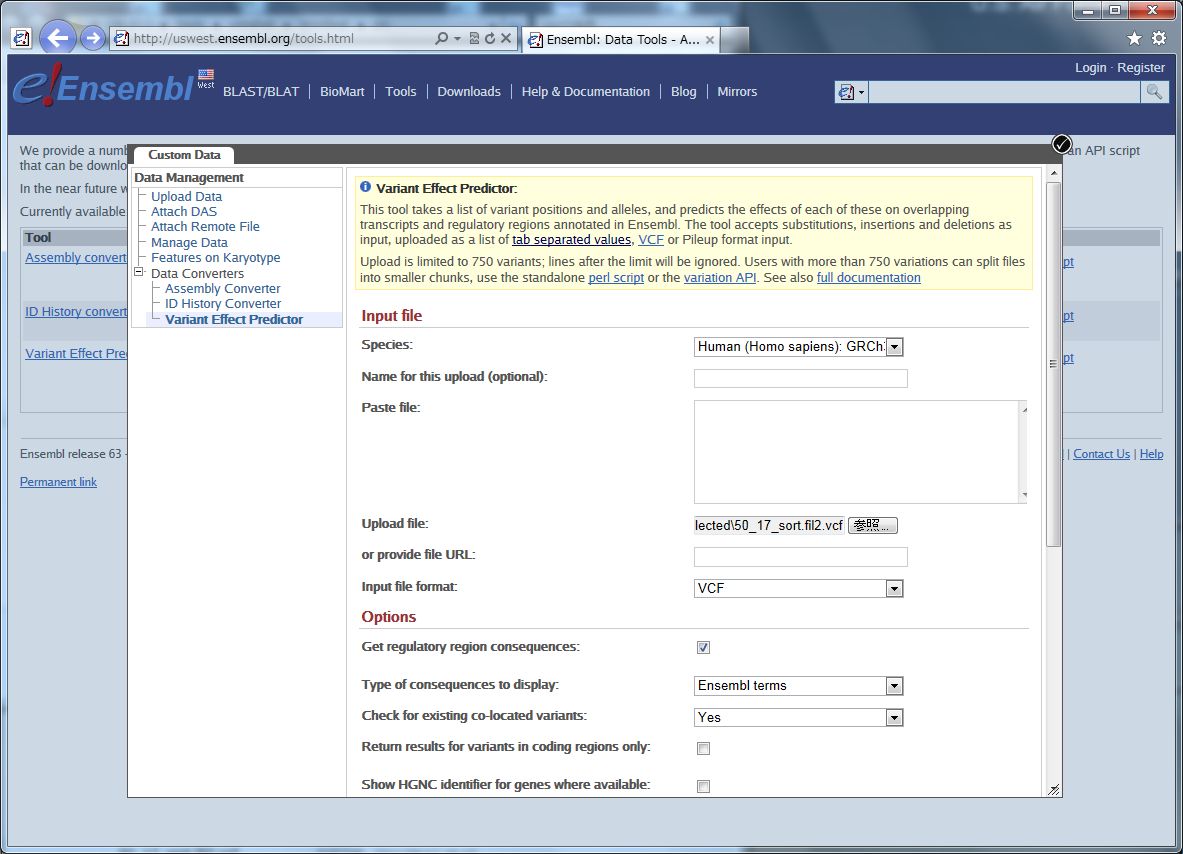
Ensembl - Variant Effect Predictor でSNPアノテーション

先日、VCFフォーマットを読みこんでSNPのアノテーションを付けるツールとして、SeattleSeq Annotationを紹介しました。ここ

ちょっと調べると、ほかにもいろいろありますね。
今日は定番?のEnsembl です。
その中の、Variant Effect Predictor というウェブツールです。


Species は、ここではヒト。 ゲノムバージョンと一緒に選びます。
ファイルの場所を指定して、フォーマット(VCF)を選びます。 
もう気づいたかもしれませんが、私はVCFを読みこめるツールが好きです。
VCFは変異レポートファイルのデファクトスタンダード。
書き込める自由度も高く、ほぼ満足です。
VCF自体を人間が読むことはあまり無いでしょうが。


追加するアノテーションを選びます。
ここからはヒトのデータのみです。

Non-Synonymous SNP(アミノ酸コーディング領域で起こる一塩基変異で、コードされるアミノ酸を置換するもの)について、その影響を予測するために、SIFT、PolyPhen、の2種類のスコアをアノテーションします。

その下のフィルタリングオプションは、マイナー・アレル・フリークエンシー(MAF)で、データをカットできます。
Nextを押して実行すると、検索が始まります。
こんな画面がでたら終了。
HTMLを「別のタブまたは別画面」で開いてみましょう。 そのまま開くと前に戻れないので注意!

HTMLのレポート画面です。 
Ensembl-IDとか、SNVの遺伝子上の場所、変異のアノテーション、アミノ酸変異があるものはその機能への影響度合い、などがリストで表示されます。


すぐ上のスクリーンショットには、Coding領域にあるNon-Synonymous SNVがありますね。
SIFTとPolyPhenの値も右にあります。
SIFT=tolerated(0.07); PolyPhen=benign(0.16) 
このうちPolyPhenの値とDescriptionについては以前SeattleSeqのところでちょっと書きましたね。
SIFTについてはまた次回。

さて、HTMLのほかに、テキストでダウンロードもできます。
これは後で編集するのに便利でしょう。

もうひとつは、
Ensemblのゲノムビューワーへのリンク。私は使ったことはことがないですが。 こんな感じでSNVの位置がわかります。


このEnsembl Variant Effect Predictorですが、残念ながらウェブ上で行うにはデータ量MAX780変異と、制限があるそうです。
それ以上の変異を解析するには、Perl APIという手があります。


2011年8月18日木曜日

IGVがVCFフォーマットに対応!

うちのベランダでは、今年流行りの緑のカーテンを、ゴーヤとアサガオでやっています。
アサガオは去年の分子生物学会で、九州大学の方から分けてもらったいろんな原種を種から育てました。 白のアサガオがきれいです。

緑のカーテンはそれなりにいいんですが、うちのすぐ前には適当に木が生い茂る公園があるんですね。
そこから飛んできたセミが、うちの緑のカーテンに止まって、夜な夜な鳴き続けるんです。
深夜2時くらいまで鳴いています。
静寂をくれ~!

さて、IGV (Integrative Genomics Viewer http://www.broadinstitute.org/igv/ )のサイトを久しぶりに見てみたら、バージョンアップしていました。
Version2のベータだったのが、いつの間にかVersion2.0.4に!
こまめにチェックしなくてはいけませんね。

追加機能として個人的に良かったのは、VCF4フォーマットが取り込めること。
これでNGSデータからSamtoolsなどで検出してきた複数サンプルのSNPデータを、そのまま並べて表示できます。
ちゃんとソートしてから作ったVCFフォーマットを用意し、IGV toolsで、インデックスを付けるのを忘れずに。

こんな感じ。

2011年7月29日金曜日

SeattleSeq Annotation : WebベースのHuman SNP機能予測システム

SeattleSeq というサイトをご存じでしょうか?
ワシントン大学が運営する、ヒトSNV機能予測データベース&システムです。

Web上でデータをやり取りします。
ユーザはSNVのリストファイルをアップロードして、欲しいアノテーションにチェックを入れ、メールアドレスを入力して、ボタンを押して、後は待つだけ。
インターネット上にデータを投げるわけですから、機密性が低い、公共データやデモデータ、自分で責任の負えるデータ、でやるのが無難です。

ファイルのフォーマットは割合と自由です。ここに詳しく
公共データのReadファイルから、マッピング、SNV検出してきた結果ファイルVCFフォーマットを入れてみましょうか。
VCFフォーマットの場合はちょっとコツがいりまして、SNVのみの結果にしなければいけません。
もしSNVとInDelが混ざって出力されているVCFの場合、InDelのデータは除きます。
VCFからSNVとInDelを分けて別々のファイルに保存するには、
こんなawkファイルを作って、

----------------Separate_SNV_and_InDel.awk     ここから------------------------------
/^#/    {
    print $0 > "snv_only.vcf";
    print $0 > "indel_only.vcf";   
    next;   
    }
   
/^[^\t]+\t[0-9]+\t[^\t]*\t[atgcATGC]\t[a-zA-Z]\t/   {
    print $0 > "snv_only.vcf";
    next;   
    }   
   
    {   
    print $0 > "indel_only.vcf";   
    next;   
    }
------------------------ここまで---------------------------------

awk -f separate_snp_indel.awk [あなたのファイル.vcf]

なんてコマンドを打つと、2つのファイルができて、snv_only.vcf ファイルにはSNVのみのデータが、
indel_only.vcf にはInDelのみのデータが作られます。
このコマンドはあるBio-info仲間が教えてくれたものですが、簡単で重宝しています。

さて、もうひとつ、VCF 4.0 ファイルであることを示すため、できた snv_only.vcf ファイルの先頭行に
##fileformat=VCFv4.0
という一行を入れてあげます。

sed -e "1i ##fileformat=VCFv4.0" [あなたのファイル.vcf]  > [あなたのファイル2.vcf]
これで準備OK。

SeattleSeqの画面を見てみましょう。 http://snp.gs.washington.edu/SeattleSeqAnnotation131/
ヒトゲノムのバージョンが、hg18 と hg19 の2つあるので、hg19を選択。

メールアドレスを入力し、ファイルをUpします。
あとは欲しいアノテーションにチェックを入れて、Submitボタンを押せばOK!
画面が切り替わり、ジョブの進行状況が確認できます。
しばらくすると、メールアドレス宛てに、メールで結果ファイルのURLが届きます。

そこをクリックして、ファイルをダウンロードします。

これがアップロードしたVCFファイル

そしてこれが、SeattleSeqの結果


New で示したところが、SeattleSeqで新しくつけられたアノテーションですね。
VCFフォーマットを保ったまま、INFO のところにrs番号をはじめ、SNVの分類、アミノ酸置換の種類、配列、GranthamScore、PolyPhen分類、などが新たについています。

以下の例で言うとこれらは、rs番号はrs3748597、SNVの分類(FD)はNon-synonymousでmissense、アミノ酸置換(AC)はイソロイシンからバリン(ILEからVAL)、GranthamScore(GS)は29、PolyPhen分類(PH)はpossibly-damaging、というようなことが書かれています。

1 888659 rs3748597 T C 149 . DP=11;AF1=1;CI95=1,1;DP4=0,0,3,8;MQ=60;
FQ=-60;DN;DT;DA=C/T;GM=NM_015658;GL=NOC2L;FG=missense;FD=missense;
AC=ILE/VAL;PP=300/750;GS=29;PH=possibly-damaging;CP=0.5990;CG=2.300;AA=C;
CN=2294,3274,30362;HA=12.1;HE=6.7;HC=6.2;DG;DV=by-frequency,by-cluster;
PS=MAAAGSRKRRLAELTVDEFLASGFDSESESESENSPQAETREAREAARSPDK
PGGSPSASRRKGRASEHKDQLSRLKDRDPEFYKFLQENDQSLLNFSDSDSSEEEE
GPFHSLPDVLEEASEEEDGAEEGEDGDRVPRGLKGKKNSVPVTVAMVERWKQA
AKQRLTPKLFHEVVQAFRAAVATTRGDQESAEANKFQVTDSAAFNALVTFCIRD
LIGCLQKLLFGKVAKDSSRMLQPSSSPLWGKLRVDIKAYLGSAIQLVSCLSETTV
LAAVLRHISVLVPCFLTFPKQCRMLLKRMVVVWSTGEESLRVLAFLVLSRVCRH
KKDTFLGPVLKQMYITYVRNCKFTSPGALPFISFMQWTLTELLALEPGVAYQHA
FLYIRQLAIHLRNAMTTRKKETYQSVYNWQYVHCLFLWCRVLSTAGPSEALQPL
VYPLAQVIIGCIKLIPTARFYPLRMHCIRALTLLSGSSGAFIPVLPFILEMFQQVDFN
RKPGRMSSKPINFSVILKLSNVNLQEKAYRDGLVEQLYDLTLEYLHSQAHCIGFP
ELVLPVVLQLKSFLRECKVANYCRQVQQLLGKVQENSAYICSRRQRVSFGVSEQ
QAVEAWEKLTREEGTPLTLYYSHWRKLRDREIQLEISGKERLEDLNFPEIKRRKM
ADRKDEDRKQFKDLFDLNSSEEDDTEGFSERGILRPLSTRHGVEDDEEDEEEGEE
DSSNSEDGDPDAEAGLAPGELQQLAQGPEDELEDLQLSEDD* GT:PL:GQ 1/1:182,33,0:63


ここで登場した、granthamScoreとpolyPhen、ほかにもscorePhastCons(CP)、consScoreGERP(CG)などは、塩基の変異によりアミノ酸が置換されるとき、これがタンパク質にどれくらい影響を及ぼすかの予測された指標です。

Grantham Scoreは、アミノ酸が変わるときに隣近所のアミノ酸との間にどれだけ化学的な影響を及ぼすか、分子量や極性などをもとに数値化しています。
conservative (0-50)、moderately conservative (51-100)、moderately radical (101-150)、radical (>151) というような分類もあるようです(Li et al. J Mol evol. 21, 58-71(1984).)

PolyPhen は、他の生物種とのホモログの配列情報から、変異があった箇所の配列保存性、化学的な特徴、タンパク質構造やドメイン情報をもとに、この変異がタンパク質の機能に及ぼす影響を数値化します。
probably damaging (>2.00)、possibly damaging (1.50-1.99)、potentially damaging (1.25-1.49)、borderline (1.00-1.24)、benign (0.00-0.99) という分類があるようで、SeattleSeqではこの分類表記になっていますね。
ちなみに、PolyPhenは現在、PolyPhen-2というのもありますが、こちらはアカデミック・非営利機関のみ利用できます。

SNVを探してから、missense のSNVのみを抽出し、そのアミノ酸変異がタンパク質にどれくらい影響を及ぼすのか、という研究は昔からありました。
現在はNGSのおかげでどんどん新しいSNVが見つかっています。
その塩基の変異が、タンパク質レベルでどのように働くのか、というテーマは今後も続いていくでしょう。
まずはPolyPhenなどの予測アルゴリズムを用いて、分子レベルの機能変化をスコア化し、数個に絞った後で、(今はここで終わっている論文がほとんどですが)今後はタンパク質の3次元構造モデリングなどを行ったり、アッセイに持ち込んで本当にタンパク質の活性が変化するのかを確かめたり、する研究も増えていくかもしれません。


2011年7月2日土曜日

Ion Torrent データセット(2) クオリティチェック

先日、Ion Torrent PGM のデータセットが、Ion Torrent 社のホームページまたはBGIのFTPからダウンロードして誰でも使えるということを紹介しました。 Ion Torrent データセット
そのデータとは、E.coli O104-H4 の de novo sequence です。 
このことを書いた後、ある方と、クオリティの話をしました。


ということで、本日はクオリティチェックの結果を書きます。
使ったファイルは、Ion Torrent 社のサイトから取得した、LB226692株のfastq ファイルの、64.fastq ファイルです。 本当は64.fastq - 71.fastq まで、8ファイル全部やりましたが、ここに示すのは64.fastq ファイルのみということで。

使ったツールは、FastQC と、PRINSEQ です。
両方とも同じようなツールです。
FastQCはPCの上で動くのに対し、PRINSEQはクラウド上で動くのが違いです。
ちなみにPRINSEQは、Internet Explore 9 ではまだうまく動かないみたいです。
FireFox、Google ChromeではOKでした。

FastQCの方が有名?
PRINSEQもいいですよ。
左下のUpload Fileをクリックして、ファイルを指定して、Upします。
でも難点は1つずつしかファイルをUPできないこと。 

ではここから、
  1. リード長のばらつき
  2. リードにおけるクオリティの変化
  3. GCコンテンツ
 に絞って、結果を見ていきましょう。 2つのツールの結果画面を交互に示します。

リード長のばらつき (Length Distribution)
FastQC
PRINSEQ
108塩基長のリードが最も多いようです。
ばらつき具合はグラフから一目了然ですね。

リードのクオリティ (Read Quality Distribution)
FastQC
PRINSEQ

多くのシーケンサーデータ同様、Readの最初はクオリティが高いですね。 
後ろの方に行くに従ってだんだんと低くなり、90塩基付近では10を切ってしまいます。

GC含量 (GC Content Distribution)
FastQC

PRINSEQ

確かE.coliのゲノムはGCリッチで50%位だったと思います。まちがってたらすみません。
このデータもリードのCG含量が平均50%ですので、まあ、想定内でしょう。


FastQCとPRINSEQを例に、リードのクオリティチェックをしました。
本当はもっとメニューがあります。
FastQCはWindowsでも動きます。
PRINSEQはインターネットにデータを送り、結果はWebブラウザで閲覧します。
とっても簡単なので、是非一度、自身でお試しください。

2011年6月19日日曜日

Ion Torrent のデータセット

ヨーロッパで先月末に発生して1500人以上が感染、17人が死亡した、大腸菌O104-H4。
日本のニュースでも話題になりましたが、これは最初、新種の大腸菌ではないかと報道されました。
(読売新聞6月3日欧州で広がるO104、新種の可能性…WHO)

やがて、ドイツと中国、その他のチームによってゲノムが読まれ、これが新種ではないものの、ハイブリッドな特徴を持つ厄介な菌であることがわかりました。 BGIによると、
このE.coliは、下痢原性大腸菌の一つのカテゴリーである腸管凝集性大腸菌 enteroaggregative E. coli (EAEC) の系統ですが、志賀毒素を産生するファージゲノムを自身のバクテリアゲノムに組み込み、さらに多薬剤耐性遺伝子をもゲノムに組み込んでいたことがわかりました。
環状ゲノムのサイズは 5,278 kbp で、ほかに 88 kbp, 75 kbp, 1.5 kbp の3つのPlasmidから成るとのこと。
通常、志賀毒素を出す遺伝子、多剤耐性遺伝子は、ファージが関係するのですが、このE.coliは自身のゲノムにこれら遺伝子を組み込んでいることから、暫定的にShiga toxin-producing enteroaggregative Escherichia coli (STpEAEC) と呼ばれているそうです。
腸管出血性大腸菌 enterohaemorrhagic E. coli (EHEC) に特徴は似ているけれど別の名前で呼ばれているんですね。知りませんでした。

さて、前置きが長くなりました。 
このドラフトシーケンシングに用いられた機器が、半導体シーケンサー Ion Torrent PGM です。 
(実はBGIは、PGMのほかにIlluminaのマシンも使って読んでいるのですがそれはさておき)
Ion Torrent社のホームページへ行くと大きく宣伝しているのがわかるでしょう。

今はまだ数少ない、PGMのデータ(この大腸菌のリード)はここから入手できます。
Sffフォーマット: http://lifetech-it.hosted.jivesoftware.com/docs/DOC-1621
Fastqフォーマット: http://lifetech-it.hosted.jivesoftware.com/docs/DOC-1516
もしかするとユーザー登録が必要かもしれません。
また、アプリケーションノートやビデオなどは、Ion Torrentを良く知るために大変役に立ちますのでお勧めです。
念のため申しますと、私は Ion Torrent 社及びライフテクノロジーズ社と、特別な関係、があるわけではありませんのでご安心下さい。 

ひとつ断わりをいれておきますが、Ion Torrent社のサイトから落とせるデータは、BGIが読んだデータではありません。
ストレインが違います。
現在5つのストレインでゲノムが読まれていて
  • TY2482 (BGI in collaboration with University Medical Centre Hamburg-Eppendorf)
  • LB226692 (Life Tech in-house in collaboration with University of Muenster)
  • H112180280 (Health Protection Agency, Colindale, UK)
  • 2 isolates, unnamed (Gottingen Genomics Lab, Germany)
BGIはTY2482を読んでいます。
Ion Torrentのサイトから落とせるデータは、LB226692のデータです。
BGIのデータを使いたい方は、
NCBI SRA からは、SRX067313 で検索すると出てきます。
BGIのサイトからは、ftp://ftp.genomics.org.cn/pub/Ecoli_TY-2482
フォーマットはfastqです。

解析、de novo assembly については、彼ら(BGI)のワークフローが参考になるかと思います。
バクテリアゲノムアセンブリを初めてされる方は見ておいて損は無いでしょう。
http://climb.genomics.cn/Ecoli_TY-2482
見てわかる通り、BGIのチームは、IlluminaとIon Torrentの両方で読んで、アセンブルしました。
Ion Torrent PGM データのアセンブリに、Newbler を使ったのですね。
Roche 454 と同じ sff フォーマットなのでこれが使えるのでしょう。
PGMは、sff を出した後、fastqでも出力してくれます。 これならvelvetなどフリーツールでも使えますね。
現在、PGM に付属するソフトには、残念ながら独自のアセンブリツールが無いので、今のところPGMを使って de novo assembly をしようとすると、アセンブリソフトを別に求める必要があります。


さて、Ion Torrent のサイトから入手できる、LB226692のデータに話を戻しますね。
先のサイトから、sff のファイルをダウンロードしてきました。
8ファイル(8ラン分)あります。
私はRocheの機械を持っていませんし、アカデミアではなく企業の人間なので、タダでNewblerは使えません。
fastqを落としてアセンブってもいいがせっかく sff のフォーマットがあるのでできればsffのままアセンブりたい。 
さて、、、どのアセンブリツールを使おうか。

手元にちょうどCLC Genomics Workbench があるのでそれでやってみることにします。
最初に言い訳がましくなりますが、このPGMのデータだけを使ってアセンブリしても、1本にはなりません。
BGIは、7ランのPGMのデータ、200x以上のIlluminaのシングルリード、さらにIlluminaペアエンド、を使って読んでやっとドラフトゲノムを完成させています。
私がこれからお見せしようとしているのは、PGMのsffデータだけでアセンブルしたら、どれくらいのContigができるのか、というものです。
CLC のGenomics Workbenchには、sff フォーマットがインポートでき、アセンブルも簡単にできます。

取り込んだ後の様子

アセンブルした後のマッピングした結果のContigリスト

Contigをクリックしたときの様子

データ量: 8ラン分のデータ、平均98bpの117万リード、合計114Mbp

アセンブルに要した時間: 1分10秒
マシンの性能: 64Bit Linux, メモリ24Mb

Contigについて(200bp以上の長さのみ)

2,700本のContigができました。 最長16,000 bpでした。
ふーん、こんなもんかな。
こんどはちゃんと配列の前処理をやってからランしようかと、思った次第です。

と、ここで終わってしまっては結構さみしいので、次に、BGIのTY2482のリードデータを使って、
Ion Torrent 7ラン分 + Illumina 200x分 のハイブリッドアセンブリをやってみました。
フォーマットはfastq です。 結果をまとめると、

データ量: 合計 20.5 M reads, 1.8 G bp
ランタイム: 15分
Contigについて
512本のContig、最長224,799 bp、N50 = 60,618 bp!
実はBGIはペアエンドでも読んでいるのですが、データは公開されていません。 
ゆえにこれは、Ion Torrent PGM +Illumina GAII シングリリード のハイブリッドアセンブリの結果、です。
ショートリード(GAII)とロングリード(PGM)がうまく互いを補いながら、長くつないでいるのでしょうね。
ちなみにCLC Genomics Workbench のパラメータはデフォルトです。
このソフトについてはこちらを参照
http://www.w-fusion.com/J/CLC_wb.html 

・・・・・・今回は少し長文になりました。


大腸菌についての参考資料
広島県保健環境センター研究報告,No.12,p1-12,2004
http://www.pref.hiroshima.lg.jp/hec/press/pdf/kenkyuhoukoku12/01.pdf