ラベル シーケンサー の投稿を表示しています。 すべての投稿を表示

2015年9月5日土曜日

久しぶりにこちらも更新!

ご無沙汰しています!
最後に「ショートリードの憂鬱」を更新したのが2012年なので、もうすぐ4年になりますか。
4年前まであんなにショートカットの彼女に想いを寄せていたのに、急にロングヘアの彼女に浮気して、気がついたらやっぱり昔のショート彼女も、手がかかったけど良かったなあ、って戻ってきた感じでしょうか。
あー、例え悪いですね。女子からは引かれそう。

冗談はそのくらいにして、もちろん最近までロングリードに夢中になっていたのですが、やっぱり気になっていたというか、最近はクリニカルシークエンスなどが熱いですよね。
これはやっぱり現在はショートリードの独壇場。
もちろんロングも頑張っていますが、もう少し時間がかかるかな。

で、「憂鬱」だった4年前のショートリード解析も、今やどんどん進化して、「快適」とまでは言わないまでも、「たまに若干憂鬱」くらいにはなってきたんでは無いでしょうか?
いやいや、まだすごい大変だよ!
という声が聞こえてきそうですが、その大変さというのも、4年前とはレベルが違うでしょう。

NGSが一般のライフサイエンスの現場に浸透していくにつれ、必ずしもインフォマティシャンではない研究者でも扱える機器になりました。
どんな分野でもそうですが、最先端の研究・誰もやったことの無い研究、パイオニア的な研究者は自分でツールを作らないといけません。
技術が汎用的になって、ある程度原理を理解した研究者が自分の研究にその技術を応用しようとするときは、優れた汎用ソフトウェアが必要になります。
汎用ソフトウェアでは自分のやりたいことができない、あるいは自分で解析する時間が無い、というかたは、受託解析を外注するでしょう。

私もかつて前職で、ちょうどNGSが日本に広まりつつある時期、汎用ソフトウェアを売ってサポートしていたり、受託解析サービスをしていました。
お客さんが100人いれば、100通りの質問、要望をします。
大変でしたが、本当に革命的な技術が広がるときの、ダイナミックな動きを肌で実感することができました。

今も、よりメーカーサイドに身を置きましたが、刺激的なのは変わりません。
むしろ、ロングリードの質問は、ショート側にいたときからは想像がつかないもの。
海外に出張すると、日本にはまだ入ってきていないビジネスや技術と触れることも多いです。
カリフォルニアという場所柄、競合企業にいたひとが会社を離れて新しいビジネスを始める、なんて普通。
ひとの動きは日本とは比べ物にならないですからねえ。


さて、しばらくロングヘアの彼女に浮気していたわけですが、この業界にいると、ショートヘア彼女の周りが騒がしくなっているのがよーくわかるのです。
ショートヘア彼女はモテるんですよ。
いろんな奴が周りにいる。
私もそんな状態を放っておくわけがない!

と、いうわけで、ショートリードについてのネタ、ちょっと紹介します。

  1. NGS解析を超高速にするサーバ「DRAGEN」について
  2. クラウドでの解析「DNAnexus」「iOMICs」について
  3. SalesForceを使ったLIMS「Third Wave Analytics」について
  4. そのほか、クリニカルシークエンス について
お楽しみに!


2012年1月23日月曜日

PacBio 更新中

今年から別ブログ「パックマンの挑戦」で、今話題?のPacific Biosciences のシーケンサーのことを書いています。
ご存じのとおり、HiSeqやSOLiDや454とは全く違うシステムで、覚えることが多くて大変です。
ここではデータ解析のことだけではなく、ウェットにも触れようと思いますので、よろしければのぞいていって下さい。

今のところ唯一、PacBioについての日本語のブログです。多分。

2011年11月21日月曜日

メチレーションをダイレクトに検出するシーケンサー

シーケンサーは塩基配列を読むもの

というのはSanger型から始まってSolexa型、454型、SOLiD型、Ion Torrent型等、今までのシーケンサーの常識です。
でも、配列だけではなく、メチレーションの有無も同時に読んでくれたら・・・
これがPacBioではできる(らしい)のです。 

Flusberg et al. Direct detection of DNA methylation during single-molecule, real-time sequencing.
Nat Methods. 2010 Jun;7(6):461-5.
昨年のthe Advances in Genome Biology and Technology (AGBT)のポスター(実際には行っていないんですけど)から注目していたのですが、PacBioのSingle Molecule Real Time (SMRT)シーケンスを使えば、塩基の修飾も配列と同時に検出することができるようなのです。

SMRTテクノロジーについては以前、
PacBio データの特徴 1 と 2 に書きました。

SMRTからの塩基配列データは、パルス (4種類の異なる光)として出力されます。
(AGBTポスターより)

パルスから得られる情報には、塩基そのものの他にも、一塩基が読みとられる時のパルスの幅 Pulse width (PW) と、次の塩基が読みとられるまでのパルスの間隔 Interpulse duration (IPD) もあります。
このIPDが、塩基が修飾されていると変化するのです。
具体的には、Aがメチル化されている N6-methyladenosine (mA) の場合、Tと結合する部分のNにメチル化が起こっているため、Tと結合するのが遅くなるそうです。
そうすると、メチル化されたAのパルスの間隔 IPDが、メチル化されていないAと比べて大きくなります。 (下図の上がメチル化A、下がコントロールA。 メチル化Aの後、次のTまでの間隔が、コントロールのAからTまでの間隔と比べて大きいのがわかります)
この原理を用いて、メチル化されているアデノシン(に限らずシトシンも)を見つけよう! ということです。
でもこの検出方法は、うまくいくのでしょうか? 

論文ではまず、人工的に作ったメチレーション配列とコントロール配列199塩基を、両方とも何百回も同じところを読んで、平均のメチル配列のIPDと、非メチル配列のIPDを比較しています。
これを見ると、必ずしもメチル化された箇所のIPDが大きく変化するわけではなく、その周辺の塩基のIPDがより影響を受けることがわかりました。
縦軸が塩基ごとのIPDの比(メチルサンプル/ 非メチルサンプル)の平均で、横軸が塩基のポジション、▲印がメチル化の場所です。
上からN6-methyladenosine、5-methylcytosine、5-hydroxymethylcytosine の順で、それぞれN=346、504、393 だそうです。

どうでしょう? メチル化された塩基の場所のIPDが変化しているものもありますが、その前後で大きく変化を示しているパターンのものもあるのがわかります。
N6-methyladenosineでは、メチル化塩基とその5番めの塩基
5-methylcytosineでは、2番、3番、6番めの塩基
5-hydroxymethylcytosineでは、2番、6番めの塩基
のIPDが大きく変化しています。 (縦軸の値が異なるのに注意)

このようなパターンがあることは、メチル化の種類も見分けることができる、ということです。
既存のバイサルファイト法のような形では不可能でしょう。

もちろん何百回も読まなくても、数回、しかし繰り返し同じ所を読むことで、メチル塩基と非メチル塩基を区別できるそうです。 
SMRTのCircular topology型DNAテンプレートなら可能なのです。
赤線がメチルAを含むテンプレート、青線がコントロールです。
5回読めばはっきりメチルテンプレートとコントロールの、メチルAのパルスが区別できることを示しています。

人工配列はもういい、という方のために、彼らはDNA adenosine methyltransferase positive (dam+)の大腸菌から取り出したC. elegans fosmid 配列をも読んでいます。
比較対象は、Whole Genome Amplification(WGA)したコントロール配列です。
これは3.7kbの配列にフォーカスして解析しています。
dam+ のIPDをコントロール(WGA)のIPDで割った、IPD Ratio が縦軸です。
Aメチル化はGATC配列に起こりやすいので、non-GATCの塩基(○)とGATC塩基(■)を分けています。
N=106で、平均IPDをプロットしています。

全体的に、non-GATC塩基はIPD ratio が2以下なのに対し、GATC塩基(メチル化塩基)は、IPD Ratioが3から7の間にいるので、区別できる! ということは言えるかな?
ちょっと2500塩基付近の下のGATCが微妙ですが。

実際、これからの技術ですね。
IPDの変化のパターンは、メチル化の種類にだけ依存しているのか、周りの塩基によっても違うのか、生物種によっても違うのか、光学的な条件によっても違ってくるのか。

でも、希望は持てます。 一度パターンがわかってしまえば、シーケンスするだけでメチル化の種類もわかってしまうのですから。

2011年9月27日火曜日

PacBio データの特徴 2

PacBioの実験ワークフローで、とてもユニークなのがテンプレートの形です。
ダンベル型のSMRTBellというそうです。

Travers et al., A flexible and efficient template format for circular consensus sequencing and SNP detection (2010). Nucleic Acids Research 38, e159.
DNAをフラグメント化して、断片の両端をエンドリペア後、輪っか配列(プライマーのため)を付けてAのダンベル型テンプレートができます。
左端の、輪っかの部分がシングル鎖になっていますね。ここにプライマーがくっつきます。
ポリメラーゼは、DNAの二重鎖のところを押しのけて、プライマーの先に、相補鎖に正しい塩基を合成していきます。
テンプレートは、ずーっといくと一周しますね。
そうしたらまた、Bのように、今合成した通りにもう一度合成をするのです。
つまり、インサートの長さに依存することなく、何度でもシーケンスが可能です。

これがダンベル型テンプレート。
このままの形がスタンダードです。

インサートの長さがものすごーく長い(数10kbとか)とき、全部読むことはできないので輪っかの近いところだけを読むことになります。 これはMait-Pairのような感じです。
Strobeと呼ぶそうです。

もうひとつはインサートの長さは適度で、テンプレートを何周も読む方法。
何度も何度も同じ配列を読むことになるので、精度は上がります。
Circular Consensusと呼ぶそうです。

ここから先は、スタンダードのテンプレートの話です。
SMRTでは、インサートを全部読むので、Read長=インサート長、になります。(SMRTについては前回のブログを参照)
しかし、全部読み切れなかったインサートもあるでしょう。
そんな、「途中まで読めたインサート」配列が混じっている状態のReadのことを、Subreadと呼ぶそうです。
Subreadがいくつか集まってRead(=インサート配列)を形成する、ということです。

ですから、SMRTで読んだ解析結果には必ず、
Subread の平均の長さ
Read の平均の長さ、95パーセンタイルの長さ、・・・
など、Subread とReadの両方の情報があるのが普通でしょう。

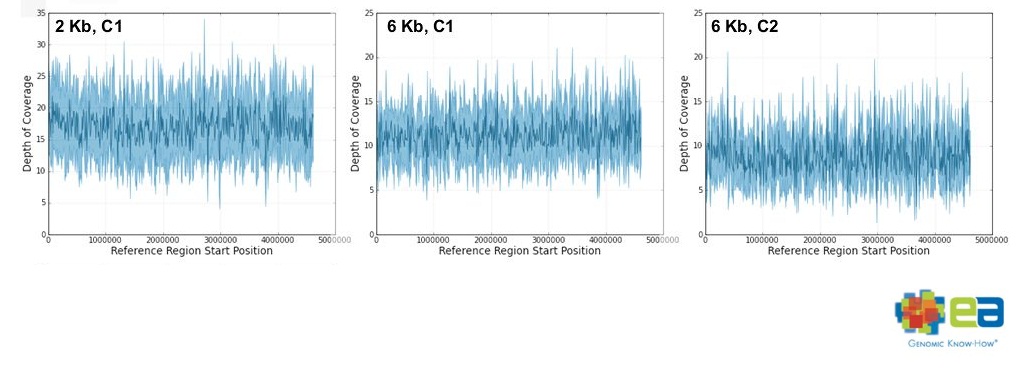
前回紹介した、Expression Analysis社のWebセミナーで紹介していたのは、SMRTで大腸菌のゲノムを読んだときのデータ解析についてです。
深夜2時過ぎのことでしたので私の記憶が正しく無い箇所もあるかもしれません。

2kbと6kbの2種類のインサートを読んでいました。
SMRTのひとつのセル(フローセルのような単位)で、34~108 MbのMappableなデータが出力されました。
平均1500塩基長、プロトコルを改良すると2700塩基長を一度に読めていました。

特徴のひとつは、大腸菌ゲノムに対するカバレージが一定だったことです。
普通、GC含量のばらつきなどにより、読みにくかったりする箇所がどうしても出てくるものですが、
それが比較的無くカバレージが一定で、
2kbインサートが6.4~17.1カバレージ
6kbインサートが6.7~11.2カバレージをゲノム全体で保持していたそうです。

精度ですが、Subreadのレベルの精度は85%程だったそうです。
これがSMRTの精度だと一般的に言われると、15%は間違い? 結構高いね、と思われそうですが、SubreadではなくRead、あるいは何度も繰り返して読んだ時のConsensusともなると、96.46~99.39%まで向上していたそうです。 

何度も読むというのは、賢い方法です。
ダンベル型テンプレートならでは?
今はまだ、バクテリアサイズのゲノムシーケンスに用いられているPacBioのSMRTです。
ランニングコストがどれくらいなのかはわかりませんが、もっと汎用的に使われる時はもうすぐ来るのでしょうか。
個人的には、機械が大きすぎ! って思います。
もうちょい、コンパクトにならないのか・・・

2011年7月6日水曜日

MiSeqのデータセット

イルミナ社も、いよいよデスクトップ型シーケンサーをリリースするそうです。
それに先立ち、早くもデモデータセットが公開されています。 
http://www.illumina.com/systems/miseq/ecoli.ilmn


このページの、右上あたりにある、Download the data から、FastqファイルとBAMファイルが落とせます。 E.coliのデータです。
サイズが大きく、ダウンロードに結構時間がかかるので、wget で取得すると良いと思います。

(wget http://.........ファイルのURL............)

ついでに、というかこっちの方が面白いかもしれませんが、BAMファイルの下の、プレゼンテーションファイルも落として見てみましょう。
びっくりしますが、スライドの後半部分に、MiSeqデータとIon Torrent PGMデータの比較、があるのです!
ここから先は実際にダウンロードしてからのお楽しみ?
当たり前ですが、MiSeqの方がいい! と結論しています。

カバレージで言うと、1ランで1.7Gb読めるMiSeqは、393x
一方PGMは6~8ラン読んでも11~24Mbで、2~5x

クオリティはどうでしょう?
プレゼンにも書いてあるのですが、せっかくReadファイルを落とせるので、fastqファイルを取得し、FastQCにかけてみました。
ここから先は、イルミナさんのプレゼンではなく、私が行った内容です。
ちなみにPaired-Endです。以下、R1とR2の順に示しています。

Quality Score
GC Content per Sequence


その他、リード長は151、平均クオリティはQ35/Q34、GCはどちらも50%でした。

私が気になったのは、クオリティのばらつきです。
150塩基まで読めるとはいっても、リードによっては、後ろの方は結構Qが低い塩基も含まれるようですね。
とは言っても100塩基あたりまで、平均してQ30あったのは驚きました。


実際、このデータでアセンブルをすると、どれくらいつながるのでしょうか。
先のプレゼンの中に、じつは答えはあるのですが。

2011年6月19日日曜日

Ion Torrent のデータセット

ヨーロッパで先月末に発生して1500人以上が感染、17人が死亡した、大腸菌O104-H4。
日本のニュースでも話題になりましたが、これは最初、新種の大腸菌ではないかと報道されました。
(読売新聞6月3日欧州で広がるO104、新種の可能性…WHO)

やがて、ドイツと中国、その他のチームによってゲノムが読まれ、これが新種ではないものの、ハイブリッドな特徴を持つ厄介な菌であることがわかりました。 BGIによると、
このE.coliは、下痢原性大腸菌の一つのカテゴリーである腸管凝集性大腸菌 enteroaggregative E. coli (EAEC) の系統ですが、志賀毒素を産生するファージゲノムを自身のバクテリアゲノムに組み込み、さらに多薬剤耐性遺伝子をもゲノムに組み込んでいたことがわかりました。
環状ゲノムのサイズは 5,278 kbp で、ほかに 88 kbp, 75 kbp, 1.5 kbp の3つのPlasmidから成るとのこと。
通常、志賀毒素を出す遺伝子、多剤耐性遺伝子は、ファージが関係するのですが、このE.coliは自身のゲノムにこれら遺伝子を組み込んでいることから、暫定的にShiga toxin-producing enteroaggregative Escherichia coli (STpEAEC) と呼ばれているそうです。
腸管出血性大腸菌 enterohaemorrhagic E. coli (EHEC) に特徴は似ているけれど別の名前で呼ばれているんですね。知りませんでした。

さて、前置きが長くなりました。 
このドラフトシーケンシングに用いられた機器が、半導体シーケンサー Ion Torrent PGM です。 
(実はBGIは、PGMのほかにIlluminaのマシンも使って読んでいるのですがそれはさておき)
Ion Torrent社のホームページへ行くと大きく宣伝しているのがわかるでしょう。

今はまだ数少ない、PGMのデータ(この大腸菌のリード)はここから入手できます。
Sffフォーマット: http://lifetech-it.hosted.jivesoftware.com/docs/DOC-1621
Fastqフォーマット: http://lifetech-it.hosted.jivesoftware.com/docs/DOC-1516
もしかするとユーザー登録が必要かもしれません。
また、アプリケーションノートやビデオなどは、Ion Torrentを良く知るために大変役に立ちますのでお勧めです。
念のため申しますと、私は Ion Torrent 社及びライフテクノロジーズ社と、特別な関係、があるわけではありませんのでご安心下さい。 

ひとつ断わりをいれておきますが、Ion Torrent社のサイトから落とせるデータは、BGIが読んだデータではありません。
ストレインが違います。
現在5つのストレインでゲノムが読まれていて
  • TY2482 (BGI in collaboration with University Medical Centre Hamburg-Eppendorf)
  • LB226692 (Life Tech in-house in collaboration with University of Muenster)
  • H112180280 (Health Protection Agency, Colindale, UK)
  • 2 isolates, unnamed (Gottingen Genomics Lab, Germany)
BGIはTY2482を読んでいます。
Ion Torrentのサイトから落とせるデータは、LB226692のデータです。
BGIのデータを使いたい方は、
NCBI SRA からは、SRX067313 で検索すると出てきます。
BGIのサイトからは、ftp://ftp.genomics.org.cn/pub/Ecoli_TY-2482
フォーマットはfastqです。

解析、de novo assembly については、彼ら(BGI)のワークフローが参考になるかと思います。
バクテリアゲノムアセンブリを初めてされる方は見ておいて損は無いでしょう。
http://climb.genomics.cn/Ecoli_TY-2482
見てわかる通り、BGIのチームは、IlluminaとIon Torrentの両方で読んで、アセンブルしました。
Ion Torrent PGM データのアセンブリに、Newbler を使ったのですね。
Roche 454 と同じ sff フォーマットなのでこれが使えるのでしょう。
PGMは、sff を出した後、fastqでも出力してくれます。 これならvelvetなどフリーツールでも使えますね。
現在、PGM に付属するソフトには、残念ながら独自のアセンブリツールが無いので、今のところPGMを使って de novo assembly をしようとすると、アセンブリソフトを別に求める必要があります。


さて、Ion Torrent のサイトから入手できる、LB226692のデータに話を戻しますね。
先のサイトから、sff のファイルをダウンロードしてきました。
8ファイル(8ラン分)あります。
私はRocheの機械を持っていませんし、アカデミアではなく企業の人間なので、タダでNewblerは使えません。
fastqを落としてアセンブってもいいがせっかく sff のフォーマットがあるのでできればsffのままアセンブりたい。 
さて、、、どのアセンブリツールを使おうか。

手元にちょうどCLC Genomics Workbench があるのでそれでやってみることにします。
最初に言い訳がましくなりますが、このPGMのデータだけを使ってアセンブリしても、1本にはなりません。
BGIは、7ランのPGMのデータ、200x以上のIlluminaのシングルリード、さらにIlluminaペアエンド、を使って読んでやっとドラフトゲノムを完成させています。
私がこれからお見せしようとしているのは、PGMのsffデータだけでアセンブルしたら、どれくらいのContigができるのか、というものです。
CLC のGenomics Workbenchには、sff フォーマットがインポートでき、アセンブルも簡単にできます。

取り込んだ後の様子

アセンブルした後のマッピングした結果のContigリスト

Contigをクリックしたときの様子

データ量: 8ラン分のデータ、平均98bpの117万リード、合計114Mbp

アセンブルに要した時間: 1分10秒
マシンの性能: 64Bit Linux, メモリ24Mb

Contigについて(200bp以上の長さのみ)

2,700本のContigができました。 最長16,000 bpでした。
ふーん、こんなもんかな。
こんどはちゃんと配列の前処理をやってからランしようかと、思った次第です。

と、ここで終わってしまっては結構さみしいので、次に、BGIのTY2482のリードデータを使って、
Ion Torrent 7ラン分 + Illumina 200x分 のハイブリッドアセンブリをやってみました。
フォーマットはfastq です。 結果をまとめると、

データ量: 合計 20.5 M reads, 1.8 G bp
ランタイム: 15分
Contigについて
512本のContig、最長224,799 bp、N50 = 60,618 bp!
実はBGIはペアエンドでも読んでいるのですが、データは公開されていません。 
ゆえにこれは、Ion Torrent PGM +Illumina GAII シングリリード のハイブリッドアセンブリの結果、です。
ショートリード(GAII)とロングリード(PGM)がうまく互いを補いながら、長くつないでいるのでしょうね。
ちなみにCLC Genomics Workbench のパラメータはデフォルトです。
このソフトについてはこちらを参照
http://www.w-fusion.com/J/CLC_wb.html 

・・・・・・今回は少し長文になりました。


大腸菌についての参考資料
広島県保健環境センター研究報告,No.12,p1-12,2004
http://www.pref.hiroshima.lg.jp/hec/press/pdf/kenkyuhoukoku12/01.pdf

2011年6月15日水曜日

PacBioのシーケンサーがあるのはどこだ?

こんなサイトをご存じでしょうか?
今、世界中で、どこの研究所にどんなシーケンサーが導入されているのかが、ひと目でわかるマップです。http://pathogenomics.bham.ac.uk/hts/
必ずしも全てを網羅しているわけではないと思いますが、どこにどんなシーケンサーが導入されているのか、(実際は今現在導入されているもの以外にも、導入がほぼ決定しているものも、含まれているようですが)がわかって面白いですね。

アジアではやはり中国のBGIが圧倒的! 137台のHiSeqですか・・・ 見てみたいです。137台のHiSeqが並んでいるその光景を。 でもRoche454が1台というのは意外です。 もっとあるんじゃないかな?


では今話題の、というか私が一番気にしている、PacBio RSがあるのはどこでしょう?
上の、PacBioのチェックボックスにチェックを入れると表示されます。
右側に、研究所の名前のリストも出てきますよ・・・
さすが北米には12台も!
ちなみに導入先(予定も含む)研究所の名前を見てみると、

  1. NCGR Genome Center:  NM, United States
  2. DOE Joint Genome Institute:  CA, United States
  3. National Cancer Institute:  MD, United States
  4. Wellcome Trust Sanger Institute:  Cambridgeshire, United Kingdom
  5. Monsanto:  MO, United States
  6. Tri-I biotech, inc.:  Taipei County, Taiwan
  7. Institute for Genome Sciences, University of Maryland:  MD, United States
  8. Ontario Institute for Cancer Research:  ON, Canada
  9. Leiden University Medical Centre:  Zuid-Holland, Netherlands
  10. Broad Institute:  MA, United States
  11. Cold Spring Harbor Laboratory:  NY, United States
  12. The Genome Center at Washington University:  St. Louis, MO, United States
  13. Center for Genomics and Personalized Medicine Department of Genetics Stanford University School of Medicine:  CA, United States
  14. Expression Analysis:  NC, United States
  15. University of Michigan DNA Sequencing Core/Affymetrix and Microarray Core Facility:  MI, United States
 です。 お知り合いのラボはありますか?
・・・ Japanの名前は、まだ無いですね。

今年中には、PacBio のマシン&データに触れる機会がありそうですので、今から楽しみです。

2011年5月28日土曜日

PacBio ついに一分子シーケンサーを正式リリース!

真の第三世代シーケンサー(1分子シーケンサー)として期待の高かった、Pacific Biosciences社 (http://www.pacificbiosciences.com/)のシーケンサーが、ついに正式リリースしたそうです。
ドキュメントはこちら

PacBioのシーケンサーは、今までβバージョンをThe Wellcome Trust Sanger Instituteや、Cold Spring Harbor Laboratoryなど、全世界11か所の研究所に特別に出荷していました。
それが今回、正式にリリースされたということです。

PacBioといえば、昨年、ハイチのコレラ菌をシーケンスして、それが東南アジアと近縁だということを示した論文が出ていました。(こちら

PacBioのシーケンサーは、他のシーケンサーと異なりDNA増幅を行わないので、1分子から読むことが可能です。 
そして何と言ってもその特徴は、
リードの本数は少ないが、長く読めて、ランにかかる時間が短い
ということでしょう。

およそ35,000本のリードを出力し、リードの長さは平均850~1,500塩基、ランタイムは40分

1ランあたりのコストは$100程度と言われています。
SOLiDやHiSeq等と比べると、1ランあたりのコストは安いですが、1塩基あたりのコストは高いと言えるでしょう。
しかし、一分子で読めるということ、そして理論的には1,500塩基以上の長配列も読めるというということは、今後大きなブレークスルーになることは間違いありません。
結構 でかっ !  重量800kg だそうです。

これは私の想像ですが、今や世界一多くの次世代シーケンサーを保有する中国のBGI(深)と、アジアのバイオ・ハブを狙うシンガポールのゲノムセンターは、この新型シーケンサーをすでに持っているか、近々持つことになるでしょう。 
日本では、私は、そういう噂はまだ聞いたことがありません。

PacBioは、機械だけをつくってはいおしまい、というのではなく、ちゃんと解析アルゴリズムも用意しているそうです。
PacBioデータ特有のLong Readに対応した、アセンブリ、マッピングアルゴリズム、SNP検出アルゴリズム、等々。
私はまだ試していませんが、プログラムを公開しています。デモデータ(E.coli)付きです。
DevNetサイト(登録必要)から落とせます。

PacBioは、私がいま一番気になっている会社のひとつですね(別に株式を持っているわけではありませんが)。

2011年3月26日土曜日

Accelrys Partners with Oxford Nanopore

Accelrys といえば、バイオの研究者よりもケミカルの研究者に良く知られているかもしれませんね。
Pipeline Pilot というソフトウェアが有名です。 画面(デフォルト)はこんな感じです。

このソフトは、パイプラインと呼んでいる通り、解析の流れを先ず作ります。 GUIで作ります。
「解析の流れ」は様々なパーツ(コンポーネント)を組み合わせて作るのですが、一度作ってしまえば何度も解析のバッチ処理ができ、同じ作業を何十回もやらなければいけない時などに便利です。
で、このパイプラインにはオプションで、シーケンス解析のパーツがあるのです!! 

このAccelrys社と、1分子シーケンサーのOxford Nanopore社が、パートナーシップを結んだそうです。
http://ir.accelrys.com/releasedetail.cfm?ReleaseID=557883

Oxford Nanopore社のテクノロジーは、他のどのシーケンサーとも変わっていて、ナノポア(小さい穴)の中を分子が通過するときの電荷を検出して、1分子単位で物を測るというものです。
今はNGS、DNAシーケンサーとして開発しているようですが、分子は何もヌクレオチドである必要は無いわけで、タンパク質でも化合物でも可能でしょう。
そんな将来性の高さが、Accelrysとのパートナーシップにつながったのではないでしょうか、というのは私の勝手な想像です。

Nanoporeシーケンサーは、まだリリースされていないようですが、技術は期待大ですね。

さて、最近、Accelrys社のWebinarがありました。
日本時間の24日深夜0時半から、でしたが、内容はずばりPipeline PilotのNGS Collection

今日はこれを紹介します。  
Pipeline Pilot NGS Collection 

NGS Collection は、アセンブル、マッピング、SNP/InDel/CNV検出、アノテーション、RNA-Seq、ChIP-Seqといったメジャーな解析機能はあるようです。
これらの解析機能を並列に実行できて、例えばマッピングなら異なるアルゴリズムを並列に実行し、結果を比較することができます。
アノテーションDBと連携させて、検出したSNPがどの遺伝子にあるのかわかります。
ビューワーはGBrowse2で見ることも、リストでみることもできます。
SAM/BAM, GFF3/Tabix, XML で出力できます。

リードを取り込んで、マッピングして、SNP検出して、それぞれでレポートして、SNPがあれば遺伝子のどこにあるか、それをGFFで出力、またはHTMLで表示、・・・ などという一連の流れ(パイプライン)を設計して実行! 
そんな説明とデモを見ました。

パイプラインの様子(MAQとSOAP SNPを並列処理)
SNPのリスト表示
ベン図で表示

私の印象では、ありきたりの有名なアルゴリズムはメニューにあるものの、マイナーな、というか
難しい、転座解析やバイサル解析はどうだろう? もっと見てみたい。
リスト表示やエクセルでできるような統計は簡単にできそうですね。
レポート表示は充実しているようです。

今度、トライアルをする予定なので、またご報告を。

参考資料です。 興味のある方はどうぞ。

Next Generation Sequencing Collection Overview: http://accelrys.com/products/datasheets/next-generation-sequencing.pdf
Building Novel Applications with Pipeline Pilot to Drive Next Generation Sequencing: http://accelrys.com/resource-center/case-studies/pdf/oxford-nanopore-case-study.pdf

2011年3月14日月曜日

半導体シーケンサ Ion Torrent PGM™

東日本大震災で被災された方には、心からお見舞い申し上げます。
私はその時、東京オフィスで仕事中でした。 職場のビルはかなり揺れ、ロッカーは倒れ書類が散乱しました。 
その後、都内の電車が全部ストップしたため、19kmを4時間かけて歩いて帰宅しました。 寒かった。
東京は、震度5でしたが、インフラがやられると大変だとつくづく実感しました。

その日の午前中は、ライフテクノロジーズ社の、半導体シーケンサIon Torrent PGMのショートセミナーに参加していましたので、今日はそれについてご紹介します。 

PGMPersonal Genome Machine)は、DNA合成時に放出される水素イオン(プロトン)をモニタリングして、配列を読みます。 
詳しくはこちらのサイトを見るのが良いでしょう。 カタログもダウンロードできます。

簡単にまとめると、200bpに断片化されたDNAは、SOLiDと同じように直径0.8ミクロンのビーズに吸着され、エマルジョンPCRで増幅されます。 
半導体上のウェルの表面には小さな穴が無数にあり、その中にビーズが入ります。
プライマーとDNAポリメラーゼによって、その穴の中でDNA合成反応が進むのです。
その時に一度に一種類のdNTPが流され、一塩基合成、プロトン検出の後、Washされます。次に別の種類のdNTPが流され、一塩基合成、プロトン検出の後、Washされます。

同時に反応に使われるのは一種類の塩基のみ、というのが重要です。
私も最初、プロトンの検出では塩基の種類がわからないじゃないか、と思ってました。
でも、一度にAだけを流すと、鋳型のDNAAがくるべき時は反応が進み、プロトンが放出されます。つまり、今プロトンが検出されたビーズのDNAの塩基は、Aであるとわかります。 TGCがくるべきDNAテンプレートではDNAは合成されないのでプロトン放出は起こりません。
そして、きれいにWashされます。
次に、一度にTだけを流すと、同じくプロトンが放出されたビーズのDNAの塩基は、Tだということがわかります。T以外ではプロトン放出は起こりません。
Tが2つとりこまれたときは、電荷が2倍となるため、Tが2つあるとわかります。 
言葉で書くと回りくどいですが、先のサイトを見れば一目了然でしょう。
シーケンスはこれを数百回繰り返し、塩基を読みます。 
ちょっと、Rocheのパイロシーケンスと似ています。 (開発者は454の開発者でもあるそうです)
でも、違う点は、パイロシーケンスは、プロトンではなくPPの放出とその蛍光を読んで塩基を特定するところです。

さて、DNAを最初にフラグメント化するときの、長さは現状200塩基で固定です。 これ以上の配列は今は読めません。 将来的には、ソフトウェアの向上などにより400まで読めるようになるそうです。

装置は61 cm x 51 cm x 53 cm、のベンチトップ型で、とても小さい印象です。 プリンターほど?
装置価格 998万円 (←1000万円を切る)
1ランあたりのコスト 約6万円 (今のバージョン314のチップ価格)

チップを交換することでバージョンアップ!
現バージョンのチップの名前は314チップと言います。
平均リード長は100 bp、出力は10万リード、反応は2時間くらいかかります。

次期バージョン316チップ:平均リード長100 bp100万リード、反応2時間半くらい
来年バージョン318チップ:平均リード長400bp500万リード

これらのチップを交換することで、装置の買い替えはすること無しに、バージョンアップが可能です。
ちなみにこれらチップは使い捨てです。 

出力データは塩基のテキストデータ
Torrent Suitというベースコールマシンによって、最初1ランあたり53GBDATデータは、180MB程度のsff、または60MB程度のfastqフォーマットで出力されます。
このマシンは、1台で複数のPGMのデータを処理できるそうです。
塩基配列で出てきます。 カラースペースではありません。

今後の予定
現在は微生物、ウイルスのデノボまたはターゲットリシーケンスや、アンプリコンシーケンスに用いられているそうです。
また、現在はシングルリードのみに対応ですが、今年中にはペアエンドに対応予定です。
そのうちバーコードサンプルにも対応するそうです。

ケーススタディの紹介では、ピロリ菌のゲノムシーケンスにて、GC%が高いところもちゃんと読めるらしいことがわかりました。
また、ホモポリマーが長くても、その数まで正確に読めるらしいです。
スタート時に必要なゲノム量は5マイクログラム、と結構多い?ですかね。

将来的には、1Gbのゲノムも読めるようになるので、他のシーケンサーとの差がますます小さくなりますね。
注目です。

2011年1月20日木曜日

イルミナも小型シーケンサーをリリース

イルミナと言えば、最高クラスのスループットを誇るHiSeq2000、HiSeq1000、そして導入数世界一のGenomeAnalyzer IIx が有名。
ライバルのライフテックがIon Torrentをリリースしたのと時期を同じくして? イルミナからも小型・パーソナルゲノムシーケンサーがリリースされた。
http://www.illuminakk.co.jp/product/system/miseq.shtml
その名もMiSeq (マイセックって発音?)

シーケンス方法はSequence By Synthesis、反応と同時に読む。一回ずつ反応を止めて蛍光を読み取る。 
つまり第二世代シーケンサーの特徴であるWash-and-Scanを踏襲している。
世界中のGenomeAnalyzerと同じ原理だ。 逆に言えば、今までの安定した信頼性を担保しつつ、小型化に成功した。

シーケンス時間が、数日から数時間に短縮された。
フローセルの大きさがHiSeqの10分の1になったためか。
データアウトプットはGbに届かない。少なく感じるが、タイピングやターゲットが決まっている時など、目的によってはこれでも十分なこともある。
価格は不明。今年のブレイク製品になるか。

2011年1月17日月曜日

2.5世代シーケンサー Helicos - HeliScope

前のIon Torrentと並んで2.5世代シーケンサーとも言うべき、Second GenerationとThird Generationの間に位置しそうなシーケンサーが、Helicos社のHeliScope。

一昨年前の春、日本にHelicosのひとがセールスに来た。
バイオExpoか何かだったと思う。大勢の聴衆を前に、Single Moleculeの威力と可能性をプレゼンしていた。
その時の価格は、1台1億円だった・・・

さて、それから早2年。 日本には恐らく理研以外に入っていないと思う。
Helicos社も昨年経営が厳しくなり、大胆なリストラを行った。

シーケンス自体は、1分子を読むのでPCRを行う必要が無い。
これはSOLiDなどの第2世代シーケンサーとの大きな違い。
塩基読み取りには、化学的に塩基と切断可能な箇所に蛍光を付けてその蛍光を読み取る。
Vertual Terminatorと呼ばれる通り、蛍光読み取りごとに反応を止める。
反応を止めるのは、第2世代シーケンサーの特徴だ。
ということで、HeliScopeは2.5世代シーケンサーだ。

反応を1塩基読み取りごとに止めるので、リード長も短く、最長32塩基である。
数百万の各反応は、ばらばらに進む。これは第3世代の特徴だ。
生データのエラーは結構高く、5%以上あるそうだ。
スループットやランにかかる時間は第2世代シーケンサーと大差無いだろう。

Helicos社のためにも、利点を挙げよう。
PCRを使わないので、より「真実」に近い配列を測定できる。
また、このシーケンサーは、逆転写酵素を使用することでRNAを直接読める、らしい。

どうだろう?
HeliScopeは、第3世代シーケンサーの特徴である1分子シーケンスを売りにしているが、いかんせんリード長が短く、第2世代と比べてダントツに優れたアドバンテージが無い。
市場に出たタイミングも悪かった。
その時すでにロッシュ、イルミナ、アプライドバイオの3強が大きな資金力でシェアを広げていた。
また、Pacific BioSciences(PacBio)社やVisiGen Botechnologies社は真の第3世代シーケンサーの実現可能性を示すなど、「ちょっと待てばもっといいものが出てくる」感があった。

実際、PacBio社は2010年末に第3世代シーケンサーをリリースした。VisiGen社は2010年にLife Technologies社に買収されその技術はLife Techのブランドで近々リリースされるだろう。

悲しいかな、HeliScopeは日本では全くと言うほど導入されなかった。
代理店が無く日本語でサポートが得られないのが大きいか。
それとも価格が問題だったのか。
残念だ。テクノロジーは、素晴らしいのに。

2011年1月16日日曜日

2.5世代シーケンサー Ion Torrent Personal Genome Machine

ライフテクノロジーズ社が昨年末に発表した、半導体シーケンサ
Ion Personal Genome Machine(PGM )シーケンサー
http://www.appliedbiosystems.jp/website/jp/product/modelpage.jsp?BUCD=138106&PLCD=138105&MODELCD=138098

うーむ。コンパクトでよさそうだ。
Ion Torrent社が半導体テクノロジーを利用して開発したシーケンサー。
で、SOLiDとどう違うの? 価格は? データ量は? クオリティは?

こいつは半導体チップを使用している。
基本的にはSequence By Synthesis (SBS)で、塩基が取り込まれるときの水素イオンを検出する。
カメラは不要なのでマシーンは小さくて済む。
しかし、シーケンスにはDNAテンプレートのPCR増幅反応が必要で、その後ひとつの塩基が取り込むごとに反応を止める必要がある。これはSOLiDやIlluminaのシーケンサーでは一般的のWash-and-Scanと呼ばれる方法。
この方法の欠点は、読める長さが短くなること。
はっきりとはわからないが、アウトプットリードはおそらく数十ベースの長さだと思う。

データ量はどうか?
チップ1平方cmあたり、150万のセンサーを搭載している。
1時間で約1億塩基を読むことができるという。

ライフテック社でのこのシーケンサーの位置づけは、パーソナルという名前が付いているとおり、大型のゲノムセンター向けで無いことは明らか。
ディスカバリー目的というより診断目的に向いている。
ラボや病院、クリニック単位での導入を目指しているだろう。
日本ではどうかな?
もう買ったラボはあるのかな?

2010年11月15日月曜日

シーケンサーの種類 SOLiD (2)

今月の1日、ライフテクノロジーズ社はプレスリリースを出した。
http://www.lifetechnologies.co.jp/pr101102.html
それによると、SOLiDシリーズは、近々また一新するらしい。

今までのSOLiD 4 は、そのスループットをさらに向上させ、SOLiD 5500xl に、さらに当初リリース予定だった低コスト版のSOLiD PI は、名前を変えて SOLiD 5500 になるらしい。
5500xl は、2プロ―チップまでのランが可能。 5500 は、1フローチップのランが可能。 って・・・。

で、そのスループットだが、ここにいい表がある。 ちょっと見て欲しい。

コスト/ランは、新しい5500xlシステムの方がSOLiD 4 より1.7倍以上高い!
今は180ギガベース/ランで、7500円/ギガベースだけど、将来的には(ソフトウェアの改善で)300ギガベース/ランになるらしいから、4700円/ギガベースか。 これはすごいかも。
でも、ソフトウェアの改善というところがちょっと気にかかる。 

5500/5500xl シリーズの機械は日立ハイテクノロジーズ社製。 
ということで、ハードについては信頼性があるかな? 

もうひとつ、これからの注目株は、今年の分子生物学会のランチョンセミナーで紹介される予定の、Ion Torrentシーケンサー。 蛍光色素を使わず、CCDカメラも無く、ヌクレオチドが取り込まれる時の水素イオンのリリースだけを検出してシーケンスする、この方法は画期的だ。
でもまだ製品の詳細は明らかにされていない。 
ここから先は想像だが、この新型シーケンサーは診断用シーケンサーの世界標準を狙っているのではないか。 低価格、低コスト/ラン、短いラン時間、レーザープリンターくらいの小さいサイズ、次世代の中では少ないデータスループット、長い読み取りリード長。 
どれをとっても大量スループットが必要無いラボにはちょうど良い。
あとは、使い勝手の良さ、データの精度、プロトコールの安定性、などが議論になるだろう。
いずれにせよ、まだサンプルデータなるものが無いので、これ以上のことは言わない。

それにしても、SOLiDを導入したラボは、しょっちゅう出されるアップグレードに苦労しているらしい。

2010年10月18日月曜日

Genome Analyzer II & HiSeq 2000

イルミナ社の次世代シーケンサーは4種類ある。
世界で一番使われている型の Genome Analyzer IIx (GAIIx)
汎用型を目指したGAIIx よりちょっと安い Genome Analyzer IIe
最も高性能ハイスループットのHiSeq2000
マイクロアレイのスキャナーと一体型の HiScanSQ

イルミナ社の思想は、「シーケンサーをどのラボでも使えるように」 なので、使いやすさを優先しているようだ。 
できるだけ簡単な操作性、これは正しいと思う。 出てくるデータも塩基配列なので直観的に扱いやすい。 SOLiDのカラースペースと比べるとここは大きい。

Genome Analyzerは世界で最も使われている高速シーケンサーだ。
当然論文数も多いので、この辺はアカデミアの人間には嬉しい、というか安心できるところ。
もともとのテクノロジーはSolexaという会社が考えたもので、フローセル上に固定したフラグメントDNAを、1塩基ずつポリメラーゼ伸長していく。 このときA,T,C,Gの4種類のヌクレオチドとそれぞれ4種類の蛍光色素が1つ、取り込まれ、それ以上は取り込まれない。
リバーシブルターミネーションと言われるその方法で、1つずつポリメラーゼ反応を進めては止め、また進めては止める。 一度の反応で4種類の蛍光=塩基がCCDカメラで観測される。 (ロッシュ454の場合は1度に1種類の蛍光を観測する) つまり、50塩基の読み取りには50回の反応が必要になる。

シーケンスとポリメラーゼ反応を同時に行う。 そこで Seqencing by Synthesis と呼ばれることもある。 ポリメラーゼ反応というわりには、ライゲーション反応のSOLiDと比べると試薬コストが高いように思う。

イルミナのシーケンサーはショートリードであるので、ライバルはSOLiDだ。
リードの精度はどちらも高い。
スループットはSOLiDに軍配が上がるが、どちらも十分高い。
こうなってくるとユーザはどこを基準に選択したら良いのか?
自分で実験するなら、使いやすいかどうか、操作性、ランニングコスト、メーカーサポートの質、を基準にすると思う。 イルミナはこの点に加え、世界中にユーザーが多い、という優位性があるので選ぶ人も多いだろう。

僕の印象だが、イルミナ社はライバルメーカーと比べて若干閉鎖的。 
ユーザーミーティング以外にも、まだユーザーでない一般のひとに対して、あるいはシーケンサーを持っていないのだがプロジェクトの一員であるひとに対して、もう少しオープンにしてくれればうれしい。

なので、僕は必要な情報はWikiなどで得ている。たとえばここ。
http://seqanswers.com/
結構スレッドを立てると、誰か答えてくれるので、不満はない。
ここでも、イルミナのユーザが圧倒的に多いふうに思う。

2010年10月9日土曜日

シーケンサーの種類 - SOLiD

SOLiD ‐ そのままググると、ビジネスコンサル会社とかCAD設計ソフトだとかがひっかかってきてなかなかシーケンサーにはいかない。 SOLiD ABI で引くといい。

Sequence by Oligo Ligation and Detection というユニークな手法のシーケンサーを初めて見たのが2007年の分子生物学会だった。 最初、本当にこんな方法で配列が読めるのかな、って疑問に思ったひとは多かっただろう。 そして、何度聞いても、ツーベースエンコーディングの仕組みを忘れてしまう。
僕が学生の時は、シーケンスといえばサンガー。 これだけ覚えればゲルもキャピラリーも同じだった。 ところが今や、PyrosequenceからSequence by Synthesis、SOLiDと、次々に増えて、そのうち第3世代、第4世代と…ああ、覚えられないよー!

さて、今日はSOLiDに絞る。 理由は、僕が最初に見た第2世代シーケンサーだから。

2010年10月現在の最新機種はSOLiD 4 hq
この表はSOLiD4のもの。 SOLiD4のリンク先
hgはこのバージョンアップ版で、驚くべきはそのスループットで、この表の3倍、最高300ギガベースが1ランで出せるらしい。
ヒトゲノムが30億塩基対、つまり3ギガ。 その100倍だ!!
ついでにライバルのイルミナHighSeq2000はこの通り
最高200ギガを可能にしている。

SOLiD4hqとHighSeq2000、どちらもこれ以上スループットを上げることは厳しいか? 
違いはサンプル調整の最後、DNAフラグメントの増幅方法にある。
SOLiDはエマルジョンPCRといって、ビーズにフラグメントを結合させてPCR増幅を行い、そのビーズごとガラススライドの穴に固定させる。 (引用:Metzker (2010) Nature Reviews Genetics v11, 31)
これはロッシュの454と同じ方法だ。 SOLiDはこのスライドの穴をより高密度にすることで、スループットを上げてきた。

イルミナのGenome Analyzer、HighSeq2000はPCRをスライドの上で行う。 ブリッジ増幅というこの方法が特徴だが、この方法は物理的にスライド上に結合できるフラグメントの数が制限されてしまう。 そこでHighSeq2000では、スライドを2枚に増やし、上下に配置することでスループットを上げた。

さて、話をSOLiDに戻す。 ライフテクノロジーズ社、旧アプライドバイオ社のホームページは、情報の宝庫だ。 ほとんどの資料が無料で手に入る。 たとえ顧客で無くてもだ。
ここから先もそんなものから引用し、編集している。

SOLiDの一番の特徴は、そのシーケンスの方法だ。 ポリメラーゼを用いないとは!
(以下、ライフテック社のホワイトペーパーを元にコメント)


詳細は、メーカーのこのホワイトペーパー をご覧いただきたい。 ひじょうに細かく、かつ分かりやすく書かれている。
想像するに、SOLiDの方法は発売当初、なかなか世間に受け入れなかったのだろう。 何しろデータがATGCの塩基配列ではなくて、0123の数字なのだから!!  研究者にとっては扱いにくいことこの上ない。

2年前、ある学会でSOLiDのデータを「信頼に足らない」と言っていたある人がいた。 2年前と言えばまだソフトウェアも未熟で、PCのスペックも低く、そもそもSOLiDの特徴を完全に理解している研究者もいなかったのかもしれない。 その先生の発言力は国内ではそこそこ大きかったので、SOLiDがいまいち使いにくい、という評判が広まってしまった感がある。 しかし、僕の感じる限り、データ解析に関してはそんなことはない。 精度は高いし、スループットも十分だ。 
今はカラースペースの0123情報でも十分扱えるソフトウェアがある。 PCのスペックも上がった。
それに、ここが一番大事だが、ライフテクノロジーズジャパン社の社員は、顧客満足度を上げようと態度で示している。 営業、マーケティング、サポート、と皆、お客さん以外にも親切で、情報公開をしている。 もし、旧アプライドバイオ社にあまりいい印象をもっていないひとがいたら、過去のことは水に流して欲しい。 あまり贔屓にすると関係者じゃあないかと疑われるのでこの辺に。

あと、SOLiDの利点は、ランニングコストが安いこと。 なぜって、インビトロジェン社と合併したおかげで試薬代がほとんどタダになったから。 
今や、ギガベース当たりいくら、っていう価格で比較するとSOLiDがダントツ安い。 パーソナル1000ドルゲノムに達するのもSOLiDが一番かもしれない。