ラベル NGS解析の種類 の投稿を表示しています。 すべての投稿を表示

2016年1月13日水曜日

MiniSeq !? MiSeqの立ち位置は?


前回、学会の期間中は新製品の発表が良くある、って書きましたが、なんとイルミナから出ました。
その名もMiniSeq

ぱっと見、NextSeqに似ていますが、サイズはMiSeqよりも小さいようです。
そして使い勝手が良くなったとのこと。
スペック的にはMiSeq v2とあまり変わらない。
Specification Sheetから抜粋

High outputモードでのスループット
  • 2x150bpが、24時間でアウトプット6.6~7.5 Gb
  • 2x75bpが、13時間でアウトプット3.3~3.75 Gb
  • 1x75bpが、7時間でアウトプット1.65~1.875 Gb

Med-Outputモードでのスループット

  • 2x150bpが、17時間でアウトプット2.1~2.4 Gb


今はまだリサーチオンリー機器なので、そのうち、MiSeq Dxのように、MiniSeq Dxなんてのが出てくるんでしょうね。
そうするとMiSeqの立ち位置は?


2015年9月8日火曜日

超高速でNGS解析 DRAGEN(2)

DRAGENという製品は、アメリカ・サンディエゴに本社を置く、Edico Genome Inc.という会社が開発しました。
この会社、2014年のThe Scientist Top 10 Innovations の1位に輝いたベンチャーです。


DRAGENサーバの速さの秘密は、FPGAにあります。
ん? なんのこっちゃ?

FPGAとは、field-programmable gate array
直訳すると、「現場でプログラム書き換えできる集積回路」
「現場」って何?
簡単に言うと、「後でハードウェアを書き換えることが可能な集積回路」

ICやLSI(大規模集積回路)は後で書き換えができない集積回路ですが、一般に半導体というとこれらを連想する方が多いのではないでしょうか?
私も小学生の頃、欲しかったパソコン(結局高価すぎて買えませんでしたが)の雑誌を読んでいて、ICとかLSIとかの名前を知った記憶があります。
トランジスタがたくさん集まって小型化したのがIC、さらにたくさんのIC回路を集積して、高度な計算に使用されるのがLSI、そんな説明だったと思います。
配線が固定なのは当たり前なので、後で回路をプログラムで書き換えることができるチップがあるなんて、知らなかった、というかたもいるでしょう。

LSIなどとは別に、ハードを作った後に、回路を自由に書き換えできるのがFPGAです。
歴史的には1970年代からPLD(Programmable Logic Device)というものがあったそうで、主に製品開発途中で回路を書き換えするのに広く使われていたそうです。
今では、製品を出荷した後でも、回路の書き換え(バージョンアップなど)ができるように、書き換え可能な集積回路が多く使われているとのこと。
このサイトに歴史から原理・応用まで詳しく説明されています。 
開発者向けではありますが、こういうサイトもFPGAに詳しいです。

私はこの辺、全然素人なので、FPGAについてはこれくらいにしておきます。
ま、要するに、DRAGENサーバとは、「FPGAを使ってNGS解析専用に回路を書き換え、また後で書き換えも可能にした大規模集積回路と、専用に作られたソフトウェアが乗っかった、NGS解析サーバ」
です。


EdicoGenome社が提供するDRAGENボード
これがDRAGENボードです。

真ん中にあるDRAGENと書かれたプロセッサが、書き換え可能なFPGAプロセッサ。
両サイドにある4枚のメモリに、リファレンス配列をハッシュ化して記憶します。
プログラムがハードウェアに直接書かれているので、通常9時間かかる解析が、たった20分で終わる、というふうに超高速に解析を行なうことができるのです。

ゲノムパイプライン(リシークエンス&変異解析)の場合、マッピングはbwaと同じ、smith-watermanアルゴリズムを使用、変異解析はGATK-HCと同じ、隠れマルコフモデルを使用。
詳細は間もなく論文で明らかになるはずです。

海外では既に実績があります。
例として、
  • Children’s Mercy Hospital of Kansas City;遺伝病を抱えて生まれてきた赤ちゃんのゲノム診断には、スピードと精度が必要。DRAGENサーバにより、これまでの解析パイプラインと比べて飛躍的に速く、そして正確にタイピングすることができるようになった。 このお話は、来月のアメリカ人類遺伝学会の、Edico Genome社のセミナーにて聞けますよ。 もちろん私も聞いてきます!
  • CDC(Centers for Disease Control and Prevention)では、Edico Genome社との共同研究を通じて、微生物ゲノムの研究に使用されているそうです。また、
  • PerkinElmer社のNGS解析パイプラインに採用されたり(この記事参照)、
  • Harvard大学やStanford大学では、300カバレッジのヒトリシークエンス解析を10分の1の時間(60時間→6時間)で完了したり(このニュース参照)、
と、まだこれからですが、ゲノムシークエンスの解析の分野で、久々にすごい技術革新が登場したという印象があります。

興味ありませんか?


解析サーバは前回のブログ記事のスペックです。
このサーバでMiSeqからHiSeqXまで対応できるとのこと。こちらのサーバは買取り。
これにボードが付いてきて、ボードは年間レンタル。
解析するデータ量に従って課金されるランクが変わるシステムです。
携帯電話みたいな感じですね。 一応、「パケ放題」も対応してますがX10システムでもない限り必要ないでしょう。

興味ありませんか?

無料トライアルもできます。
データを送って、解析結果を返却、のような流れです。
これでは速さが実感できませんが、タイムスタンプを信じて下さいね。

もう一度、

興味ありませんか?(しつこい)

価格とかトライアルとかについて知りたい! という方は是非、ご連絡下さい。
まだ弊社のホームページは準備されていないので、私宛のメール宛てにお願いします。

ken_osakiあdigital-biology.co.jp 「あ」を@に変えて下さい

gmail, hotmail 以外のメーラーで送って下さいね。
ホームページ準備されたらそのリンクに書き換えます。

もちろんこのブログにコメントでもOKです。

アメリカ人類遺伝学会の後に、もっと情報アップデートできると思います。
楽しみにしていてください!

2011年10月14日金曜日

Exome と SNVについてのメモ 1

最近ブログを更新していませんでした。
先月末から何ていうのでしょう、一種のスランプみたいな、そんな気分でしたので。
もう脱しつつあるので、大丈夫です。

昔からGWASなどでSNPを解析しているひとには常識かもしれませんが、NGSが出た最近やっとSNP(SNV)を始めてみようかな、というひとには意外と「目からうろこ」なことがあります。

私もSNPを昔からやっていたわけではないので、たまに論文を読んでいて気づかされることがあります。
で、そういうことを他の研究者と話すと、意外とその人も知らなかったり。

具体的には、NGSを使ってWhole Exomeをやっている解析で、SNVを見つける、そのときのワークフローです。
当たり前のように行っていたフィルタリングのプロセスで、「なぜそのフィルタリングを行うのか」「基本となる考え方・仮定は何か」という基本的なところがおろそかになっていたと。
そこについてメモ書きのようですが、まとめました。

Exome解析の最終目的は、おおよそ、「疾患原因となるSNVの候補を絞り込む」ことになると思います。
そこで、
  1. ヒトならヒトのExon領域をカバーしたターゲットシーケンスを行い、その領域で十分な厚みを持ってマップされた場所から、SNVを見つけます。 (例:SureSelectなどでターゲットキャプチャーしたあとIlluminaマシンで大量に読み、BWAでヒトゲノムにマッピング、キャプチャー領域にてSamtoolsでSNVを検出)
  2. 検出されたSNVの場所とリストをもとに、dbSNPなどのデータベースに無いものを抽出
  3. さらにその中からNon-synonymousのSNV(アミノ酸置換を伴うSNV)のみを抽出
  4. そして残ったnsSNVのうち、患者複数のサンプルで共通するものを選び出す
ここから先はその疾患原因SNV候補のバリデーションになるわけですが、上記の1~4の処理はそれぞれ理由、というか前提や仮定があります。
それを理解していないでなんとなくパイプライン的に解析を処理していると、後から他の研究者に突っ込まれてタジタジ・・・となってしまう!

以下はSNPをやってたひとには当たり前すぎることを書いていると思います。 どうぞお許しを。

  1. Exon領域をキャプチャーする大前提は、テーマとしている疾患の変異を、遺伝子のコーディング領域から探そうとしているわけです。 つまりコーディングされない場所にいくら疾患原因SNVがあったとしても、それは見ないことにしよう、としています。 
    もちろんコーディング領域は重要です。 しかしそれ以外の転写制御領域のSNVも大変重要ですが、これらは一般的なExomeでは解析対象から外されます。 
  2. dbSNPに無い、SNVのみを探すというのは、一見、新規性を探索するのに合理的な方法です。 この疾患原因SNVは非常にレア、珍しいという前提があります。 しかし、データベースに登録されるSNVは、現在爆発的に増え続けていますので、既知であっても自分の研究疾患では新規ということは十分あり得ます。
  3. Non-synonymousのSNVに絞るということは、アミノ酸置換、あるいはフレームシフト、ミッセンス等を伴うような変異は特に重要だという前提に立っています。 「この疾患の原因は、アミノ酸変異を伴うSNVだ」 という仮定がそこにあります。 そうでない仮定の場合にNon-synonymous SNVに絞るのは適当でないでしょう。
    また気をつけるべきは、Alternative Exon(スプライスバリアント)の存在です。 これを無視してSNVを見つけているケースが多いのではないでしょうか。 ゲノムのSNVではなく遺伝子コーディング領域中のSNVとなると、スプライスバリアントが異なればそのSNVの有る無しの意味は大きいはずですよね。 (言葉足らず)
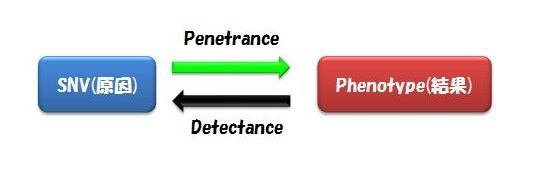
  4. 複数の患者のサンプルで同じSNVを見つけるというのは、そのフェノタイプに共通するSNVを見つけ出すということです。 SNV(原因)があれば必ずそのフェノタイプ(結果)を引き起こすことをComplete Penetranceと言います。 一方、そのフェノタイプ(結果)には必ずそのSNV(原因)が見られるときをComplete Detectance と言います。
    つまりこのフィルタリングは、全ての患者に共通するSNVがあるはずだ、という前提に立っているわけです。


まとめると、上記のワークフローで解析するための前提・仮定は、
「全ての患者に共通するSNVがあって、かつそのSNVを持っていればかなりの確率でその疾患にかかり、そのSNVはとても珍しく、そしてタンパク質のアミノ酸コードを変えることで疾患フェノタイプを引き起こす」 
ということになりますでしょうか。

今日は字ばっかりですみませんでした。

2011年9月27日火曜日

PacBio データの特徴 2

PacBioの実験ワークフローで、とてもユニークなのがテンプレートの形です。
ダンベル型のSMRTBellというそうです。

Travers et al., A flexible and efficient template format for circular consensus sequencing and SNP detection (2010). Nucleic Acids Research 38, e159.
DNAをフラグメント化して、断片の両端をエンドリペア後、輪っか配列(プライマーのため)を付けてAのダンベル型テンプレートができます。
左端の、輪っかの部分がシングル鎖になっていますね。ここにプライマーがくっつきます。
ポリメラーゼは、DNAの二重鎖のところを押しのけて、プライマーの先に、相補鎖に正しい塩基を合成していきます。
テンプレートは、ずーっといくと一周しますね。
そうしたらまた、Bのように、今合成した通りにもう一度合成をするのです。
つまり、インサートの長さに依存することなく、何度でもシーケンスが可能です。

これがダンベル型テンプレート。
このままの形がスタンダードです。

インサートの長さがものすごーく長い(数10kbとか)とき、全部読むことはできないので輪っかの近いところだけを読むことになります。 これはMait-Pairのような感じです。
Strobeと呼ぶそうです。

もうひとつはインサートの長さは適度で、テンプレートを何周も読む方法。
何度も何度も同じ配列を読むことになるので、精度は上がります。
Circular Consensusと呼ぶそうです。

ここから先は、スタンダードのテンプレートの話です。
SMRTでは、インサートを全部読むので、Read長=インサート長、になります。(SMRTについては前回のブログを参照)
しかし、全部読み切れなかったインサートもあるでしょう。
そんな、「途中まで読めたインサート」配列が混じっている状態のReadのことを、Subreadと呼ぶそうです。
Subreadがいくつか集まってRead(=インサート配列)を形成する、ということです。

ですから、SMRTで読んだ解析結果には必ず、
Subread の平均の長さ
Read の平均の長さ、95パーセンタイルの長さ、・・・
など、Subread とReadの両方の情報があるのが普通でしょう。

前回紹介した、Expression Analysis社のWebセミナーで紹介していたのは、SMRTで大腸菌のゲノムを読んだときのデータ解析についてです。
深夜2時過ぎのことでしたので私の記憶が正しく無い箇所もあるかもしれません。

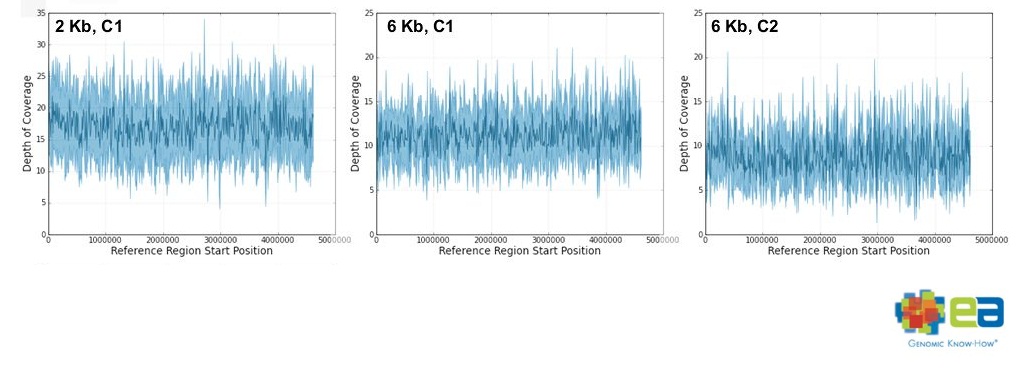
2kbと6kbの2種類のインサートを読んでいました。
SMRTのひとつのセル(フローセルのような単位)で、34~108 MbのMappableなデータが出力されました。
平均1500塩基長、プロトコルを改良すると2700塩基長を一度に読めていました。

特徴のひとつは、大腸菌ゲノムに対するカバレージが一定だったことです。
普通、GC含量のばらつきなどにより、読みにくかったりする箇所がどうしても出てくるものですが、
それが比較的無くカバレージが一定で、
2kbインサートが6.4~17.1カバレージ
6kbインサートが6.7~11.2カバレージをゲノム全体で保持していたそうです。

精度ですが、Subreadのレベルの精度は85%程だったそうです。
これがSMRTの精度だと一般的に言われると、15%は間違い? 結構高いね、と思われそうですが、SubreadではなくRead、あるいは何度も繰り返して読んだ時のConsensusともなると、96.46~99.39%まで向上していたそうです。 

何度も読むというのは、賢い方法です。
ダンベル型テンプレートならでは?
今はまだ、バクテリアサイズのゲノムシーケンスに用いられているPacBioのSMRTです。
ランニングコストがどれくらいなのかはわかりませんが、もっと汎用的に使われる時はもうすぐ来るのでしょうか。
個人的には、機械が大きすぎ! って思います。
もうちょい、コンパクトにならないのか・・・

2011年9月23日金曜日

PacBio データの特徴 1

PacBioのシーケンサーから出てくるデータはどんなものなんだろう?

その前に、「4分でわかるPacBio-SMRTテクノロジー」をYouTubeで見つけたので、SMRTって何だ?ってひとはまずはここから。

テクノロジーについてもっと詳しく知りたい方は、PacBioのホームページか、この論文がお勧めです。
Schadt et. al., "A window into third-generation sequencing". Hum. Mol. Genet. (2010) 19 (R2): R227-R240
SMRTの特徴は、DNAを1分子単位で、PCRによる増幅無しで、結構長く読めるということです。
Single Molecule Real Time の略です。

ガラススライド上に無数の小さなポケット(ZMWs (zero-mode waveguides) )があり、その穴の底には、DNAポリメラーゼが固定されています。 この穴は非常に小さく、波長600nmまでの可視光線は通り抜けできない構造になっています。

シーケンスは、プライマーがアニールされたDNA鋳型がポリメラーゼに取り込まれ、反応準備が完了します。
4種類の異なる蛍光の付いた塩基が、ZMWsの外から入り込み、DNA鋳型に取り込まれると蛍光が切り離されてZMWsの穴の底で光ります。その光は底から30ナノメートルまでしか届きません。
スキャナーはその光を検出します。 底にはポリメラーゼが固定されているので、その近くで観測される光は、取り込まれた塩基による光しかない、というわけです。

でもランダムにZMWsの外からも蛍光付きの塩基が入り込むので、偶然ポリメラーゼ近辺に来て、蛍光が検出されてしまうことはないのでしょうか。 
IlluminaやSOLiDのような、蛍光検出一回につき余分な蛍光を洗い流す、Wash-and-Detectはしていません。 
あくまでもReal-Timeにポリメラーゼが自然に塩基がとりこまれるままで読んでいるのです。

トリックは、ポリメラーゼに塩基がとりこまれる速度はミリ秒単位、それ以外のZMWs内の塩基の出入りはマイクロ秒単位、という時間の差にあります。
ミリ秒単位で光らないと、DNA鎖の塩基として認識しないのです。


先日、Expression Analysis(http://www.expressionanalysis.com/)というアメリカの会社がPacBioのデータ解析Webセミナーをやっていたので、深夜2時だったけど参加してみました。
PacBioのデータって、どんなんだろう? すごく興味があったせいか、3時までずっと起きていました。 次の日会社・・・

さて、SMRTテクノロジーで検出される塩基は、ポリメラーゼがReal Timeに合成する速度と関係が深くなります。
ということは、塩基の検出される時間幅は、一定では無いということです。
Webセミナーの中でもそれを言っていました。
同じAGCCATと読んでいても、ポリメラーゼは機械ではありませんので、1塩基読むのに時間のばらつきが生じます。 これが画像からのシグナル変換、いわゆる一時解析を複雑にしている原因なのです。
とは言っても、PacBioの機械・ソフトは、これを何とか解決しているのでしょう。 でなければ商品化していませんよね。

次は、PacBioのデータを解釈するにあたって絶対必要な、リード、サブリード、ダンベル型のSMRTBellテンプレート、について説明します。


2011年9月5日月曜日

NGSでmicroRNA解析 1

microRNAというのは、タンパク質にはならない、いわゆる non-coding RNAの仲間です。 
それ自身で標的のmRNAの3’-UTRなどに結合し、標的mRNAを分解します。
microRNAは発現制御機能を持った、RNA分子なのです。

と、ごくごく簡潔にまとめましたが、microRNAについては、多くのレビューや教科書に記載がありますので、詳しくは書かないとして。 Wikipediaでもかなり情報が得られますよ。


さて、microRNAの解析は、長らく、TaqManアレイやその他のマイクロアレイ、PCRなどが主流でした。
近年、NGSでもこれを解析している例が見られます。
実験プロトコールとして一般的なのは、
  1. トータルRNAを抽出して
  2. ゲルに流した後18-30塩基のあたりを切り出し
  3. Small RNAを精製して
  4. ライブラリーキットにある通りアダプターを付け
  5. cDNA合成し
  6. ライブラリーをシーケンサーで短めに読む
というものです。

短めに読む、というのはフラグメントの長さが 18-30塩基を予想しているからで、35、6塩基も読めば十分全体をカバーするからです。
ゲノムや転写産物を読む場合は、できるだけ長く読めたほうが良いですが、microRNAは短くてもOK、むしろちゃんと正確に読めることが大切です。

さて、シーケンサーが無事データを出力しました。
ここからデータ解析です。

microRNAの解析では、リードのアダプタートリミングは大切です。 (microRNAに限ったことではありませんが)
読んでいるフラグメントの長さが短い分、5’側のアダプターから読んだ時に、フラグメントを読み切り、3’側のアダプターまで読んでしまうことがあるからです。
そのため、3’側のアダプターをトリミング(除去)することが必須です。

次に、トリミングした後のリードが、短くなりすぎると、後でマッピングする際にNon Specificにマップされる恐れがあるので、これも除きます。 15‐18塩基以下の短いリードは除去するといいかもしれません。

リードがきれいになったところで、いよいよマッピングです。 でも何に対して?

一例を示します。 今度参考文献も示しますね。

  1. 先ずゲノムにマッピングし、マップされなかった配列はごみとして除去する
  2. ゲノムに当たったリードを回収、miRBase の配列(precursor, mature, mature*)にマッピング
  3. miRBaseの配列にぴったり当たったリードは、既知のmicroRNAとして保存
  4. miRBaseの配列に当たらなかったリードは、次に、microRNA以外の、既知のnon-coding RNA (piwiRNA, snRNA, snoRNAなどの) 配列に対してマッピング
  5. non-coding RNAにも当たらなかったリードは、念のため、RefSeqのmRNA配列に対してマッピング
  6. それでも当たらなかったリードは、新規microRNA「候補」として保存

これにより、①既知のmicroRNA、②それ以外のnon-coding RNA、③新規microRNA 候補、の3種類のデータセットができる。

既知のmicroRNA、non-coding RNA については、発現量の解析をすることになるでしょう。
新規候補の解析は、少しやっかいだが、アルゴリズムが無くはないのです。

つづく

2011年7月27日水曜日

Exome 解析 non-synonymous SNVを見つけた後は・・・

Agilent社のSureSelect、Illumina社のTruSeq、NimbleGen社のSeqCap といえば、最近盛んに宣伝されているExomeの実験用キットです。
Exomeというのは、ゲノム全体ではなく、その中のExon、実際はExon+α の配列のみを選択してシーケンスする解析方法です。
原理はまず、Exonの部分配列DNA(プローブ)が用意されていて、断片化されたゲノムと、溶液中またはアレイ上でハイブリし、Exonプローブにハイブリされた(キャプチャーされた)ゲノム断片だけを抽出します。
そのExon部分配列のみをシーケンスするというわけです。
実際Exonの上を何塩基ごとにプローブが設定されているのか、という情報は非公開ですが、Exon全てをキャプチャーできるようには設計されているそうです。

このキットが普及されるにつれ、Exome、特にヒトExomeの研究が盛んになってきました。
それまでは1000GenomeやCancer Genome Instituteのようなゲノムセンターでの研究が一般的でしたが、昨年末ごろから一般の大学の研究室レベルでも、ヒトExome実験が行われるようになってきたようです。

実験プロトコールもいろいろ大変なのでしょうが、私はデータ解析屋なので、データが出てからの料理に興味があります。

世の中に、フリーツールはたくさんありますが、Exome解析は、それらをいくつも組み合わせていく、一見面倒くさいけれどもエレガントなワークフローです。

ちょっと検索すると、
NGS Surfer's Wiki のリシークエンス
BioStar
などにパイプライン(ワークフロー)が出てきます。

まとめると、
  1. リードをゲノムにマッピングし (BWA)
  2. 冗長性のあるリード・Duplicateを除去し (SamtoolsやPicard)
  3. キャプチャーしたExon領域だけを取り出し (Bedtools)
  4. SamtoolsでSNVを抽出し
  5. SNVにアノテーションをつける non-synonymous SNV, missense, frame-shift など
というところまでを行っています。
SNVというのはSNPとほぼ同意語で、変異か多型かの違いです。厳密には異なりますが、ここでは同じ意味とします。

さて、Exomeの論文はたくさんありますが、その中でいいな、と思ったものを3つ
  1. Vissers et al. A de novo paradigm for mental retardation. Nature Genetics 42, 1109-12 (2010).
  2. Timmermann et al. Somatic mutation profiles of MSI and MSS colorectal cancer identified by whole exome next generation sequencing and bioinformatics analysis. PLoS One 22, e15661 (2010).
  3. Ng et al. Exome sequencing identifies MLL2 mutations as a cause of Kabuki syndrome. Nature Genetics 42, 790-3 (2010).
 3のKabukiシンドロームは、10人の患者データセットがあるのですが、10人全部に共通する新規レアSNVを見つけようとしたらうまくいかなかったのですね。 そこで10人全員ではなく9人に共通、8人に共通、7人に共通というふうにレベルを下げていったのです。
そうするとNonsense置換またはフレームシフトを起こしていたMLL2遺伝子上の変異が、10人中7人に見つかったのです。
後はちゃんとCGHアレイとサンガーシーケンスで確認しています。

2のMSI/MSSは、直腸癌の種類(microsatellite instable / stable)が違う6人の患者サンプルで、MSIとMSSとで見つかった変異にどう違いがあるか、を見ています。
それぞれのサンプルで55,000程のSNVをリストした後、遺伝子の中にあるか、タンパクコード領域にあるか、dbSNP/1000Genomeに登録されていないか、カバレージは十分にあるか、Somaticな変異かどうか、とフィルタリングしていき、最終的に「タンパク質の機能を変化させる変異であるか」というところまで行き、数十程のSNVまで絞り込んでいます。
せっかくタンパク質の3D立体構造まで表示しているので、もう少しここから先が欲しかったです。

1、2、3、共通するのが de novo SNVを見つけた後にその変異が引き起こすであろうアミノ酸置換またはフレームシフトが、タンパク質の機能にどのような影響を及ぼすか、をスコア化していることです。

1はPhyloPとGrantham、2はPolyPhen(Polymorphism Phenotyping)とMutation Taster、3はGERP というプログラムを使ってスコアを計算しています。
このような潜在的なnon-synonymous SNVの機能予測プログラムは他にも、SIFT(Sorting Intolerant from Tolerant)、PolyPhen‐2などがあります。
私も全部を知っているわけではないので(知っていなくてはいけないのでしょうが)、これらのうちの
 いくつか、多分PolyPhenとGranthamを、SeattleSeq というWebツールと一緒に紹介します。

2011年7月18日月曜日

de novo Transcriptome; 454用のベストなアセンブラーはどれだ !? 【論文紹介】

Roche 454 と言えば、パイロシーケンスでロングリードを読める代表格です。
数百塩基も読めるロングリードは、未知の配列決定にも良く使われます。
de novo のシーケンスですね。
以前、de novo Transcriptome を話題にしましたが、リファレンスが未知の生物で、転写産物配列を決定したい場合、ロングリードの454が、真っ先に使うシーケンサーの候補に挙げられるでしょう。
もちろんショートリードのペアエンドで読む、ということも可能です。
しかし、長く読めるということは、未知の配列決定において非常に大きなアドバンテージですので、454を選ぶ方は多いのです。

ゲノムではなく、転写産物を読む場合、Isoformの存在が気になります。
スプライシングのバリアントを見たい場合、やっぱりロングリードが有利でしょうか。

実は、リファレンス未知の生物のTranscriptomeを行っている研究は、結構あります。
論文になっているものだけでも、昨年紹介した、ほかにも、

Coral larval (サンゴ): Meyer et al. BMC Genomics 10, 219 (2009).
Eucalyptus grandis (グランディスユーカリ): Novaes et al. BMC Genomics  9, 312 (2008).
Sarcophaga crassipalpis (ニクバエ) : Hahn et al. BMC Genomics 10, 234 (2009).
Populus trichocarpa (ブラックコットンウツド): Geraldes et al. Mol.Ecol.Resour 11, 81 (2011).

なんかがあるようです。 (全部は読んでいませんが)

454のリードは一般的には、シーケンサーの機械に付属しているアセンブラー、Newblerでアセンブルすることが多いと思います。
でも、Newbler以外にも、ロングリードをアセンブルできるアセンブラーはいくつかあるんですよ。
そこで、454のリードをアセンブルできるアセンブラーを比較した論文を紹介します。
Kumar et al. Comparing de novo assemblers for 454 transcriptome data. BMC Genomics 11, 571 (2010).
この論文は2010年に出されていますから、今年は各ソフトもバージョンアップして、論文投稿時とは若干状況が違っていると思いますが、参考になると思います。

比較しているアセンブラーは、
  1. Newbler 2.3
  2. Newbler 2.5
  3. CAP3
  4. CLC Assembly Cell 3.0
  5. MIRA 3.0
  6. SeqMan NGen 2.1
の6つです。 CLCとSeqManは商用ソフト、Newblerはアカデミックはフリー、CAP3は非営利ならフリー、MIRAはどこでもフリー、だそうです。 
結論からいうと、Newbler 2.5が最も良いとのこと。
「454のシーケンスメーカーが作っているんだから当たり前だろ!」
私も思わず突っ込みましたが、ほかにも面白いことが書いてあるかと。

アルゴリズムの違いとして重要なところは、
CLCはde Bruijn graphを、その他の5つはOverlap-Layout-Consensus (OLC) を使っていること。

de Bruijn graphはVelvetやABySSといったアセンブラーでも使われています。
de Bruijn graphの特徴は、リードをk-merという決められた長さの塩基ブロックに切り、この部分の重なりをもとに、アセンブルをします。
k-mer = 31なら31塩基の重なりを見て、リード同士をつなげていきます。
k-merの範囲でのみ重なり具合を見るんですね。 本当はショートリードの、たくさんカバレージがあるデータに向いています。
一方OLCはクラシカルな方法?で、ペアワイズアライメントを元にしています。
より慎重に伸長していくのですね。
もちろん、6つのアセンブラーはそれぞれ、計算アルゴリズムを工夫しているので、結果はちがうのですが。

この論文では、彼らは線虫の一種をサンプルに、Roche 454 FLX を使って de novo Transcriptome をやっていました。
アダプタートリムした 741,387本のリード、約2億塩基のデータを、先の6つのアセンブラーでアセンブルしています。

最も速くアセンブルが終わったのは、CLCで4分、次がNewbler 2.5の45分。 一番遅いのがMIRAの3日。
1kb以上の長さのContigが一番多くできたのは、Newbler 2.5で7,661本、次がNewbler 2.3の6,320本。 一番少ないのはCLCの4,174本。
全Contigの合計塩基数は、一番多いのがSeqManの2,136万塩基、次がMIRAの2,134万塩基、3位はNewbler2.5の2,007万塩基。 最も少ないのはNewbler 2.5の1,446万塩基。
(詳細は同論文のTable4を参照)

Contigの合計塩基数でNewblerのバージョン2.5と2.3で成績が全然違うのにはびっくりします。
2,007万塩基と1,446万塩基ですからねえ。

6つのアセンブラーでできたContigをそれぞれBLATして、相似性・非相似性を調べ、新規配列がどれだけ作られたか、を彼らは次に見ています。
結果、MIRAとNewbler2.5は、より多くの(長い)ContigをCLCやCAP3より作ったが、その余分の配列は特に新規の配列ではなかった。 曰く、MIRAとNewbler2.5のContigには冗長性があるのではないか、と。
CLCのcontigは最も冗長性が低かったらしい。 ということは余分な配列は作らなかった。 
「待てよ、それって良いことなのか? TranscriptomeではIsoformはつきもの。」

繰り返しですが、
de Burijn graph は高カバレージの大量リードアセンブルに向いています。 なぜならアセンブルがめっちゃ速いから。
OLCは低カバレージのアセンブルに向いています。 なぜなら正確だけど、ペアワイズアライメントなので計算量がかかるから。

私の経験でも、CLCの de Burijn graph アセンブラーは他と比べて速いです。
でも、速いがゆえに、犠牲にしていることがあります。
  1. アセンブルに使われたリードの情報(どのリードがどのContig形成に用いられたか等の情報)は持たない。 他のアセンブラーではACEファイルというものを持つようです。
  2. k-mer は最大でも31です。 これはCLCの設定です。 31塩基は、ショートリードには向いているかもしれませんが、400塩基を超すようなロングリードでは短いですし、結果、Contigが断片化してしまうことがあります。
  3. Isoformの認識は失われる。 CLCのde Burijn graphの宿命です。 Contigが途中から枝分かれするようなとき、「枝」は別のContigとされます。 これを修正しているアルゴリズムは別途紹介します。
しかし、4分という速さは驚くべきことで、「とりあえずやってみよう」的な使い方には向いているでしょう。

現在、MiSeqやPGMに代表されるように、より多くの、ロングリードが出てくるようになってきています。 OLCアルゴリズムでは今後、計算速度が大きな壁になるでしょう。
ちなみにこの論文では、64bit Linuxの、普通のワークステーションレベルのPCを使っていました。


さて、同じ de Bruijn graph でも、Isoformを見つけよう! パラログを認識しよう!というコンセプトのアセンブラーが最近出てきました。
454のようなロングリードではなく、ショートリード用ですが、Trinityというものです。

http://trinityrnaseq.sourceforge.net/

最近使い始めたばかりですので、このツールについてはまたの機会に。


2011年6月19日日曜日

Ion Torrent のデータセット

ヨーロッパで先月末に発生して1500人以上が感染、17人が死亡した、大腸菌O104-H4。
日本のニュースでも話題になりましたが、これは最初、新種の大腸菌ではないかと報道されました。
(読売新聞6月3日欧州で広がるO104、新種の可能性…WHO)

やがて、ドイツと中国、その他のチームによってゲノムが読まれ、これが新種ではないものの、ハイブリッドな特徴を持つ厄介な菌であることがわかりました。 BGIによると、
このE.coliは、下痢原性大腸菌の一つのカテゴリーである腸管凝集性大腸菌 enteroaggregative E. coli (EAEC) の系統ですが、志賀毒素を産生するファージゲノムを自身のバクテリアゲノムに組み込み、さらに多薬剤耐性遺伝子をもゲノムに組み込んでいたことがわかりました。
環状ゲノムのサイズは 5,278 kbp で、ほかに 88 kbp, 75 kbp, 1.5 kbp の3つのPlasmidから成るとのこと。
通常、志賀毒素を出す遺伝子、多剤耐性遺伝子は、ファージが関係するのですが、このE.coliは自身のゲノムにこれら遺伝子を組み込んでいることから、暫定的にShiga toxin-producing enteroaggregative Escherichia coli (STpEAEC) と呼ばれているそうです。
腸管出血性大腸菌 enterohaemorrhagic E. coli (EHEC) に特徴は似ているけれど別の名前で呼ばれているんですね。知りませんでした。

さて、前置きが長くなりました。 
このドラフトシーケンシングに用いられた機器が、半導体シーケンサー Ion Torrent PGM です。 
(実はBGIは、PGMのほかにIlluminaのマシンも使って読んでいるのですがそれはさておき)
Ion Torrent社のホームページへ行くと大きく宣伝しているのがわかるでしょう。

今はまだ数少ない、PGMのデータ(この大腸菌のリード)はここから入手できます。
Sffフォーマット: http://lifetech-it.hosted.jivesoftware.com/docs/DOC-1621
Fastqフォーマット: http://lifetech-it.hosted.jivesoftware.com/docs/DOC-1516
もしかするとユーザー登録が必要かもしれません。
また、アプリケーションノートやビデオなどは、Ion Torrentを良く知るために大変役に立ちますのでお勧めです。
念のため申しますと、私は Ion Torrent 社及びライフテクノロジーズ社と、特別な関係、があるわけではありませんのでご安心下さい。 

ひとつ断わりをいれておきますが、Ion Torrent社のサイトから落とせるデータは、BGIが読んだデータではありません。
ストレインが違います。
現在5つのストレインでゲノムが読まれていて
  • TY2482 (BGI in collaboration with University Medical Centre Hamburg-Eppendorf)
  • LB226692 (Life Tech in-house in collaboration with University of Muenster)
  • H112180280 (Health Protection Agency, Colindale, UK)
  • 2 isolates, unnamed (Gottingen Genomics Lab, Germany)
BGIはTY2482を読んでいます。
Ion Torrentのサイトから落とせるデータは、LB226692のデータです。
BGIのデータを使いたい方は、
NCBI SRA からは、SRX067313 で検索すると出てきます。
BGIのサイトからは、ftp://ftp.genomics.org.cn/pub/Ecoli_TY-2482
フォーマットはfastqです。

解析、de novo assembly については、彼ら(BGI)のワークフローが参考になるかと思います。
バクテリアゲノムアセンブリを初めてされる方は見ておいて損は無いでしょう。
http://climb.genomics.cn/Ecoli_TY-2482
見てわかる通り、BGIのチームは、IlluminaとIon Torrentの両方で読んで、アセンブルしました。
Ion Torrent PGM データのアセンブリに、Newbler を使ったのですね。
Roche 454 と同じ sff フォーマットなのでこれが使えるのでしょう。
PGMは、sff を出した後、fastqでも出力してくれます。 これならvelvetなどフリーツールでも使えますね。
現在、PGM に付属するソフトには、残念ながら独自のアセンブリツールが無いので、今のところPGMを使って de novo assembly をしようとすると、アセンブリソフトを別に求める必要があります。


さて、Ion Torrent のサイトから入手できる、LB226692のデータに話を戻しますね。
先のサイトから、sff のファイルをダウンロードしてきました。
8ファイル(8ラン分)あります。
私はRocheの機械を持っていませんし、アカデミアではなく企業の人間なので、タダでNewblerは使えません。
fastqを落としてアセンブってもいいがせっかく sff のフォーマットがあるのでできればsffのままアセンブりたい。 
さて、、、どのアセンブリツールを使おうか。

手元にちょうどCLC Genomics Workbench があるのでそれでやってみることにします。
最初に言い訳がましくなりますが、このPGMのデータだけを使ってアセンブリしても、1本にはなりません。
BGIは、7ランのPGMのデータ、200x以上のIlluminaのシングルリード、さらにIlluminaペアエンド、を使って読んでやっとドラフトゲノムを完成させています。
私がこれからお見せしようとしているのは、PGMのsffデータだけでアセンブルしたら、どれくらいのContigができるのか、というものです。
CLC のGenomics Workbenchには、sff フォーマットがインポートでき、アセンブルも簡単にできます。

取り込んだ後の様子

アセンブルした後のマッピングした結果のContigリスト

Contigをクリックしたときの様子

データ量: 8ラン分のデータ、平均98bpの117万リード、合計114Mbp

アセンブルに要した時間: 1分10秒
マシンの性能: 64Bit Linux, メモリ24Mb

Contigについて(200bp以上の長さのみ)

2,700本のContigができました。 最長16,000 bpでした。
ふーん、こんなもんかな。
こんどはちゃんと配列の前処理をやってからランしようかと、思った次第です。

と、ここで終わってしまっては結構さみしいので、次に、BGIのTY2482のリードデータを使って、
Ion Torrent 7ラン分 + Illumina 200x分 のハイブリッドアセンブリをやってみました。
フォーマットはfastq です。 結果をまとめると、

データ量: 合計 20.5 M reads, 1.8 G bp
ランタイム: 15分
Contigについて
512本のContig、最長224,799 bp、N50 = 60,618 bp!
実はBGIはペアエンドでも読んでいるのですが、データは公開されていません。 
ゆえにこれは、Ion Torrent PGM +Illumina GAII シングリリード のハイブリッドアセンブリの結果、です。
ショートリード(GAII)とロングリード(PGM)がうまく互いを補いながら、長くつないでいるのでしょうね。
ちなみにCLC Genomics Workbench のパラメータはデフォルトです。
このソフトについてはこちらを参照
http://www.w-fusion.com/J/CLC_wb.html 

・・・・・・今回は少し長文になりました。


大腸菌についての参考資料
広島県保健環境センター研究報告,No.12,p1-12,2004
http://www.pref.hiroshima.lg.jp/hec/press/pdf/kenkyuhoukoku12/01.pdf

2010年10月5日火曜日

実験プロトコルを知る必要性

データ解析をやっていると、時折ふっと思うことがある。
これはそもそも何を見ているのだろう?
自分の研究ならいざ知らず、他人から預かったデータで解析だけを頼まれた場合、実態が分からないことほど、気持が悪いことは無い。

これはドライを専門にやっているひと一般に言える。
実験の本質を知らずに、出されたデータだけをいじくっても良い結果は生まれない。

そこで、実験プロトコールを知っておくことが大事だと思うのだ。
シーケンスでは、例えば全転写解析のデータの場合、Whole transcriptome protocol filetype:pdf などでGoogleれば、SOLiDのプロトコールが簡単に見つかるだろう。
これを読まなくとも、絵を見れば、サマリーをつかむことができる。
先ず、抽出したRNAは、市販のキットを使ってpoly-A付きのメッセンジャーか、リボゾーマルRNAを除いた残りのRNAのいずれかに精製される。
その後の流れは、
RNAを酵素を使って断片化し、サイズを量を測った後、RNAの両端にアダプター配列をライゲーションする。 アダプター配列はプライマーの役割も果たし、そのまま逆転写されて、RNAはcDNAになる。 cDNAは、ゲルに流してサイズが約150-250baseのところで切り取られ、PCR増幅される。 増幅されたcDNAはまたサイズを測って確認、OKなら、このフラグメントをSOLiDのシーケンスプロトコールにのせて読む。

これを知っているのといないのとでは、データ解析に向かう姿勢が全く違う、と思うのは僕だけではないと思う。 「ドライの奴らは実験なんて知らなくても、データを言われた通りに解析すればいいのだ。」と言う、ウェットの連中がたまにいるが、それは違う。 ドライの解析は、特に新しい分野では、実験過程を考慮しながら、解析手順をそれに合わせて変えていく想像力が必要だからだ。 コマンドラインのパラメータ設定のことを言っている。 

実験結果は常に、バイオロジカルなものであれ、テクニカルなものであれ、何らかのかたよりが伴う。 またドライの人間の先入観が、解析過程をじゃまするときもある。 例えば de novo assembleでは、Contigを作るのが目的だから、できるだけ長いContigを作ろうとする。 ずっとゲノムのアセンブルをやっていたドライの担当者が、ある日転写産物のアセンブルを頼まれたらどうだろう。 つい、いつものように長いContigをたくさん作ろうとするかもしれない。 N50を気にして、この値が例えば500を超えるまで、あるいは推定遺伝子数と同じだけのContigができるまで試行錯誤するかもしれない。 転写されていないメッセンジャーは決してContigにならないことに気づくまで。

実験プロトコールを知ることは、ウェットの世界を覗く一番簡単な方法だ。
わからなかったら聞けばよい。 もちろん生化学のバックグラウンドも必要だ。 そしてシーケンスを正しく理解するには、遺伝学、分子生物学、の基礎はしっかりと勉強してキープアップしていかなければだめだ。
ドライの解析なんて、大部分はコンピュータがやってくれるのだから、あわてることは無い。
ウェットの部分をしっかり理解して、それに合ったコマンドのパラメータを選べるようになったら、一人前だと思う。
やたらめったらパラメータを変えて、いい結果がでたらOKというのは、最初の確認ならばいざ知らず、2回目からは止めた方がいい。 

2010年10月3日日曜日

de novo transcriptome という分野

NGSの使われ方のひとつに、de novo transcriptome という分野がある。 これは何かと言うと、リファレンス配列が全く未知の生物の発現解析である。
普通、RNA-Seqは、リファレンス配列(ゲノム配列またはRefSeq配列)があって、これに対してリード配列をマッピングしていく。 そのうえで、マッピングされたリード配列の数を数えて、発現量を推定する。

余談だが「リード配列の数=発現量」というのは、正確に言うと違う。 リードの数は、転写産物の長さや、シーケンサーから出力された全リード数で補正(Normalize)する必要がある。 RPKMという補正値が、遺伝子ごとの発現量としては一般的で、SOLiDやGAIIに付属するソフトでもこの値で出力することができる。 でも、ディスカバリー目的、例えばエキソンのスプライシングや、未知エキソンの検出、などにはリード数そのものを比較することもある。 むしろ補正はしない方がいいと思う。

さて、話題に戻って de novo transcriptome の話をすると、これはさっきも言った通りリファレンスが無い。 ということは、出てくるデータは転写産物のショートフラグメントだけ! なので、まず、
1) リードをアセンブルしてContigを作る
2) できたContigを転写産物と仮定して、リードをContigにマッピングする
3) 後は普通のRNA-Seqと同じ
という順序になると思う。

データが出てきた後の話だ。
アセンブルは色々あるが、454ならNewbler、SOLiDやGAIIならVelvetのようなアセンブラーを使って行うだろう。
その時のTipは、ミトコンドリアやクロロプラスト由来のRNAが混ざっている場合、その配列にヒットするリードをあらかじめ除いておくと、ゲノム由来のRNAにコンタミするのを防ぐことができる。 

数時間後、めでたくContigができた。 100-mer以上の長さが数百本ある。 これは信じていいのか。 Contigはたくさんできても、それが本当に転写産物なのかは、リファレンス配列が無い時は確かめようがない。 なので、Contigを既知のタンパク質配列に対してBLASTxし、Contigがどれだけ既知の転写産物らしいか、を確かめると良いと思う。
真核生物、哺乳類、植物、など大きなくくりでタンパク質配列を用意して、それに対してBLASTxする。 さて、ここで遺伝子に紐付いたものの中に、保存性が高くてかつ塩基配列が長いものはあるか? 植物ならBIG(binding / ubiquitin-protein ligase/ zinc ion binding)などの遺伝子配列がある程度の長さで取れているか? これは、アセンブルの精度の基準なると思う。 

この De novo transcriptomeをする場合、使うべきは454のロングリードシーケンサーだろう。 実際に454を使っている文献はいくつかある。
1.Parchman TL. BMC Genomics. 2010 Mar 16;11:180. PMID: 20233449
2.Elmer KR. Mol Ecol. 2010 Mar;19 Suppl 1:197-211. PMID: 20331780
3.Kristiansson E. BMC Genomics. 2009 Jul 31;10:345. PMID: 19646242
どれもモデル生物ではない生物で、発現を見ている。
このうち面白いのが、1の文献で、これはLodgepole pine (P. contorta) のde novo transcriptomeをしている。 このケースでは、先ず464,896本のリードを、すでにゲノム配列がだいたいわかっている近縁種P.taeda の、18,921本のUnigene配列と共にアッセンブルして、めでたく6,601本のContigを得ていた。 近縁種のUnigeneと実験データのリードを混ぜてアセンブルしているのだ! これはびっくり。 これにより、P.contortaとP.taeda の間で保存されている配列を先に同定できる。 Contigに加わらなかったリードで再びde novo assembleを行い、最終的に57,086本のContigと、およそ24万本のsingletonを得ている。 24万本のSingletonって…、という突っ込みはさておき、この方法は近縁種の遺伝子がある程度分かっているときに有効な手法だろう。

http://atgc-illumina.googlecode.com/...k_090910_D.pdf
をGoogleで検索すると、トップに出てくるのが、レタスのde novo transcriptome
これはIlluminaのGAを使用している。
残念ながらSOLiDでの例はまだ出会っていない。 454と組み合わせての使用例は今後出てくるかもしれないが。

僕の経験では、当たり前かもしれないがショートリードだけでなく、ロングリードと一緒にアセンブルした方が長いContigが多くできやすい。
transcriptomeに関しては、そもそも発現していない遺伝子はリード数が少なく、アセンブルされにくいだろう。 つまりゲノムのアセンブルと違ってContigの数が多ければ良いというわけでもない。

未知の転写産物を調べるというのは、高速シーケンサーならではの使い方なので、今後増えてくると思う。 第3世代なら問題ないかもしれないが、第2世代の機械ではアセンブルという必要があるので、ここは難しくもあり、また僕みたいなデータ解析屋にとってはチャレンジングなテーマでもある。