ラベル マッピングソフトウェア の投稿を表示しています。 すべての投稿を表示

2017年11月4日土曜日

DRAGEN 名実共に世界最速のNGSサーバに! ギネスブックに載ったぜい!

今気付いたんですが、このブログの前回の記事が昨年のASHGだったんですね。
それもEdicogeonme社、DRAGENの話。
偶然ですが今回の記事もASHG、それもDRAGENの話!


ついに、ギネスブックに載ったぜ!

このニュースはすごいと思いません?
真ん中にいるジャケット来たかたがギネスのおっさんです。

どういうことでギネスに載ったのか、というと、1000人分のヒトゲノムを最高スピードで解析するシステム、ということらしいです。
私もちゃっかり記念撮影

Edicoの夜のパーティにはたくさんひとが集まり、盛り上がりました。
昨年はバンクーバーで、今年はオーランド。
バンドの生演奏やもちろんタダ飯&タダビール。もちろんプレゼンもこんな感じに、真面目にやってました。


さて、Edicogenome社のホームページに行ったかたは気づいたかも知れませんが、Dragenがクラウドサービスを始めました。
具体的にはDNA Nexusのパイプラインを使っていて、DNA NexusはAWSを使っている、というわけですが、現在はアメリカだけのサービスです。
残念ながら、AWSとの大人の事情で、日本ではクラウドサービスの予定は未定なんです。

というわけで日本ではハードウェアがありますのでどうぞ宜しくお願いします!

このギネスの話を拡散したら、問い合わせがあちこちから来ました。
日本のクリニカルシークエンスにも、Dragenサーバが使われる日も近い、かな。


2016年3月6日日曜日

DRAGENサーバ とりあえず動かしてみた(1)

この間、秋葉原で「第二回PacBio現場の会」という、PacBio Specificのセミナーをやりました。
その中で余興として、例の超高速NGSサーバ「DRAGEN」のデモをやるはずでした・・・。

まあ、いろいろあって、23日には間に合わなくて、うちの同僚Dにはプレゼンで乗り切ってもらいましたが。

そんな中、ついに、先週我がオフィスに到着したDRAGEN君。
オフィスについて早速ケースを脱がされ、裸のハードを横から見られているDragen君。かわいそうなので写真は前から

同僚Dは早速セットアップ、ヒトゲノムリファレンスを入れて、ハッシュテーブルを作って、HiSeq2000のサンプルデータを流してくれた。
20Xの全ゲノムシークエンスデータ。

パイプラインは、
  1. fastqのgzを入力データに
  2. リファレンスマッピング
  3. Bamファイルを書き出して
  4. Variant Callingして
  5. VCFを出力
という至ってベーシックなもの


で、速さなんですが、

笑ってしまうくらい速い!

Time loading reference:              00:00:00.000
Time aligning reads:                 00:07:06.006
Time sorting and marking duplicates: 00:09:37.107
Time saving map/align output:        00:09:43.040
Time partial reconfiguration:        00:00:06.019
Time variant calling:                00:09:51.977
Total runtime:                       00:17:13.450

20カバレッジヒトゲノムのマッピングからSNPコールまでが17分?
もう一度、今度は私が別のデータ(同じく約20X)でトライ

Time loading reference:              00:00:20.827
Time aligning reads:                 00:06:59.932
Time sorting and marking duplicates: 00:09:01.473
Time saving map/align output:        00:09:06.573
Time partial reconfiguration:        00:00:05.873
Time variant calling:                00:09:17.615
Total runtime:                       00:16:59.875

えっ、17分?速っ!
20Xの全ゲノムマッピングですよ!

何でこんなに速いのかは、FPGA使ってます、以外に正直説明できないのですが、とにかく速いのは確かです。

コマンドラインなんで、デモをやったとしても、はっきり言って、地味です。
ターミナル眺めているだけになるので、これなら「現場の会」で見せるとしても工夫が必要だったなーと、いまさらながら思います。


今日は、「とりあえず動かしてみたら、やっぱり速かった」という報告です。
本当はもっと大きなデータ、それもBCLから試すべきでしたけれども、手元にBCLが無かったので断念。
BCL→fastq変換も、確か10分程度で終わるはずです。
これもすごい速いですよね!!

まあ今回は、fastq.gzからの入力でも十分速いことが実感できたのでこれで良しとします。
次回は、BCLからの変換速度、いくつか解析メニューの紹介、になるかな。


というわけで皆さん、DRAGENに興味があるならば、もう日本でトライアル可能です!

一番簡単なのは、ハードディスクでHiSeqのデータを送ってもらうことでしょうか。
オフィスに到着したら、DRAGENサーバにコピーして、解析します。
(もしお客さんが解析の様子を実感したければ、ウェブミーティングなどで生中継することも可能かな?)
そして結果とログファイルを全部お返しする。という流れ。
興味がある方は、こちらからカタログ請求の下の備考欄に、「DRAGENトライアルしたい!」と書いて送ればOK!
「このサーバ、いくらですか?」 という質問にも、丁寧にお答えします。

データを外に出せない!という方は、その旨書いてくれれば、サーバ本体を貸し出すことも条件付きですが可能です。


2015年9月8日火曜日

超高速でNGS解析 DRAGEN(2)

DRAGENという製品は、アメリカ・サンディエゴに本社を置く、Edico Genome Inc.という会社が開発しました。
この会社、2014年のThe Scientist Top 10 Innovations の1位に輝いたベンチャーです。


DRAGENサーバの速さの秘密は、FPGAにあります。
ん? なんのこっちゃ?

FPGAとは、field-programmable gate array
直訳すると、「現場でプログラム書き換えできる集積回路」
「現場」って何?
簡単に言うと、「後でハードウェアを書き換えることが可能な集積回路」

ICやLSI(大規模集積回路)は後で書き換えができない集積回路ですが、一般に半導体というとこれらを連想する方が多いのではないでしょうか?
私も小学生の頃、欲しかったパソコン(結局高価すぎて買えませんでしたが)の雑誌を読んでいて、ICとかLSIとかの名前を知った記憶があります。
トランジスタがたくさん集まって小型化したのがIC、さらにたくさんのIC回路を集積して、高度な計算に使用されるのがLSI、そんな説明だったと思います。
配線が固定なのは当たり前なので、後で回路をプログラムで書き換えることができるチップがあるなんて、知らなかった、というかたもいるでしょう。

LSIなどとは別に、ハードを作った後に、回路を自由に書き換えできるのがFPGAです。
歴史的には1970年代からPLD(Programmable Logic Device)というものがあったそうで、主に製品開発途中で回路を書き換えするのに広く使われていたそうです。
今では、製品を出荷した後でも、回路の書き換え(バージョンアップなど)ができるように、書き換え可能な集積回路が多く使われているとのこと。
このサイトに歴史から原理・応用まで詳しく説明されています。 
開発者向けではありますが、こういうサイトもFPGAに詳しいです。

私はこの辺、全然素人なので、FPGAについてはこれくらいにしておきます。
ま、要するに、DRAGENサーバとは、「FPGAを使ってNGS解析専用に回路を書き換え、また後で書き換えも可能にした大規模集積回路と、専用に作られたソフトウェアが乗っかった、NGS解析サーバ」
です。


EdicoGenome社が提供するDRAGENボード
これがDRAGENボードです。

真ん中にあるDRAGENと書かれたプロセッサが、書き換え可能なFPGAプロセッサ。
両サイドにある4枚のメモリに、リファレンス配列をハッシュ化して記憶します。
プログラムがハードウェアに直接書かれているので、通常9時間かかる解析が、たった20分で終わる、というふうに超高速に解析を行なうことができるのです。

ゲノムパイプライン(リシークエンス&変異解析)の場合、マッピングはbwaと同じ、smith-watermanアルゴリズムを使用、変異解析はGATK-HCと同じ、隠れマルコフモデルを使用。
詳細は間もなく論文で明らかになるはずです。

海外では既に実績があります。
例として、
  • Children’s Mercy Hospital of Kansas City;遺伝病を抱えて生まれてきた赤ちゃんのゲノム診断には、スピードと精度が必要。DRAGENサーバにより、これまでの解析パイプラインと比べて飛躍的に速く、そして正確にタイピングすることができるようになった。 このお話は、来月のアメリカ人類遺伝学会の、Edico Genome社のセミナーにて聞けますよ。 もちろん私も聞いてきます!
  • CDC(Centers for Disease Control and Prevention)では、Edico Genome社との共同研究を通じて、微生物ゲノムの研究に使用されているそうです。また、
  • PerkinElmer社のNGS解析パイプラインに採用されたり(この記事参照)、
  • Harvard大学やStanford大学では、300カバレッジのヒトリシークエンス解析を10分の1の時間(60時間→6時間)で完了したり(このニュース参照)、
と、まだこれからですが、ゲノムシークエンスの解析の分野で、久々にすごい技術革新が登場したという印象があります。

興味ありませんか?


解析サーバは前回のブログ記事のスペックです。
このサーバでMiSeqからHiSeqXまで対応できるとのこと。こちらのサーバは買取り。
これにボードが付いてきて、ボードは年間レンタル。
解析するデータ量に従って課金されるランクが変わるシステムです。
携帯電話みたいな感じですね。 一応、「パケ放題」も対応してますがX10システムでもない限り必要ないでしょう。

興味ありませんか?

無料トライアルもできます。
データを送って、解析結果を返却、のような流れです。
これでは速さが実感できませんが、タイムスタンプを信じて下さいね。

もう一度、

興味ありませんか?(しつこい)

価格とかトライアルとかについて知りたい! という方は是非、ご連絡下さい。
まだ弊社のホームページは準備されていないので、私宛のメール宛てにお願いします。

ken_osakiあdigital-biology.co.jp 「あ」を@に変えて下さい

gmail, hotmail 以外のメーラーで送って下さいね。
ホームページ準備されたらそのリンクに書き換えます。

もちろんこのブログにコメントでもOKです。

アメリカ人類遺伝学会の後に、もっと情報アップデートできると思います。
楽しみにしていてください!

2011年8月12日金曜日

制御領域はSNP検出に不向き?

遺伝子発現のオン・オフに重要な働きをする、CpG island と その多くが存在する5'-UTR
この部分はゲノムの他の部分よりGCコンテンツが高いことが知られています。
制御領域を次世代のシーケンサーで読んで、その変異を調べようという研究がありますが、それは注意が必要だ、というレポートを見つけました。

その名も、「Next generation sequencing has lower sequence coverage and poorer SNP-detection capability in the regulatory regions」 

このレポートでは、Cancer Genome AtlasからIlluminaとSOLiDのデータをダウンロードして、まずマッピングをたくさんのツールで行って比較しています。

比較しているのは、マッピングツールは
  • Bowtie
  • BWA
  • SOAP2
  • RMAP
  • ZOOM
  • Maq
  • Novoalign
  • SHRiMP
 SNP検出には
  • MAQ
  • SOAPsnp
  • SNVmix
です。
マッピングツールのサマリーは、サプリメント資料に詳しくあります。
Smith-Waterman alignment系、Burrows-Wheeler transform系、Hash Table系、とそれぞれ。

マッピングプログラムの比較をまとめた論文は良く見かけるのですが、このレポートでは単にどれが速い・低メモリー・高カバレージだ、というのにとどまらず、タイトルにもありますが、

GC%が高い制御領域は、ゲノムの他の領域と比べてマッピングカバレージが極端に低い
よってCpG island などの制御領域でSNPを見つけたいときは気をつけよ!

と言っています。

私も今まで、カバレージと言っても、ゲノム平均カバレージ、あるいは遺伝子平均カバレージにのみ注意が行って、遺伝子の中の5'-UTR, Exon, Intron, 3'-UTR と分けて考えたことは無かったのでなるほどと思いました。

ちなみにこのレポートでは、
  • BWT系のマッパー(Bowtie, BWA)がイルミナデータのマッピングには、ペアエンド、シングルリードのどちらでも最も成績が良かった。
  • SOLiDデータのマッピングには、NovoalignCSが最も良かった。
  • SNP検出はMAQが一番良かった。
と結論つけています。 ここは異論がある方もいるでしょうが。
ただ、なんとなくですが、無難な結論ではあります。

2011年6月3日金曜日

発現解析パイプラインを作るぞ! その2: TopHat の使い方 2

さて、無事TopHatが終了し、下のような画面が出て、
accepted_hits.bam, junctions.bed, insertions.bed / deletions.bed というファイルができたとしましょう。
この3ファイルが何かについては前回説明しました。
TopHatは、コマンド実行時に指定したgtfファイルを使って、gtfに書かれている既知の転写配列情報から、Exon Junction を認識してマッピングしてくれるのです。

Exon Junctionを認識するということは、Fusion Geneも特定してくれそうです。
それは、Tophat-fusion というツールがあるのですが、また今度別のときに書きます。

さて、うまくマッピングされ、BAMファイルができました。
では次に、Samtools を使って、BAMファイルを染色体番号順にソートします。
これは後で必要になります。

samtools sort ./tophat_SRP003186_Control/accepted_hits.bam ./tophat_SRP003186_Control/sort_accepted_hits
samtools sort ./tophat_SRP003186_MCF7/accepted_hits.bam ./tophat_SRP003186_MCF7/sort_accepted_hits
samtools sort ./tophat_SRP003186_SKBR3/accepted_hits.bam ./tophat_SRP003186_SKBR3/sort_accepted_hits
最後のアウトプットに.bam と書くと、出力が.bam.bam と2重拡張子になるので注意!

次に、後でUCSCとかIGVとかのGenome Viewerで見るために、ソートしたBAMファイルにインデックスをつけておきます。
samtools index ./tophat_SRP003186_Control/sort_accepted_hits.bam
samtools index ./tophat_SRP003186_MCF7/sort_accepted_hits.bam
samtools index ./tophat_SRP003186_SKBR3/sort_accepted_hits.bam
拡張子.bai というファイルができるはずです。 これがインデックスです。

ついでにソートしたBAMファイルを、SAMフォーマットにしておきましょうか? 別に必要無いですけど、samtools に慣れていないひとは練習がてら。 
ちなみにIGVは、SAMファイルも取り込めます。その際には、IGV-toolsでインデックスをつけるひつようがあります。
また、以前紹介した、SAM-Mate というWindows 対応のRNA-SEQ解析ツールは、SAMでないと受け付けてくれません、今のところ。 
samtools view ./tophat_SRP003186_Control/sort_accepted_hits.bam -o ./tophat_SRP003186_Control/Control_sort_accepted_hits.sam
samtools view ./tophat_SRP003186_MCF7/sort_accepted_hits.bam -o ./tophat_SRP003186_MCF7/MCF7_sort_accepted_hits.sam
samtools view ./tophat_SRP003186_SKBR3/sort_accepted_hits.bam -o ./tophat_SRP003186_SKBR3/SKBR3_sort_accepted_hits.sam

 
発現変動を見るには、Cufflinksのコマンドのひとつ、Cuffdiff というものを実行します。
ソートしたBAMファイル、既知トランスクリプトのGTFファイルの2つを使います。
cuffdiff -p 4 -v /Path_to_gtf/refGene.gtf ./tophat_SRP003186_Control/sort_accepted_hits.bam ./tophat_SRP003186_MCF7/sort_accepted_hits.bam -o ./cuffdiff/MCF7
cuffdiff -p 4 -v /Path_to_gtf/refGene.gtf ./tophat_SRP003186_Control/sort_accepted_hits.bam ./tophat_SRP003186_SKBR3/sort_accepted_hits.bam -o ./cuffdiff/SKBR3
コントロール v.s. MCF-7、コントロール v.s. SK BR-3 の2つの比較ですね。
本当はリプリケートがあると良かったのですが、これはN=1です。
パラメータは単純にデフォルトで行っています。
唯一、CUPを -p 4 にしたことくらいでしょうか。

Cuffdiffのアウトプットファイルは地味で、タブ区切りテキストファイルができるだけです。
もちろん加工すればGenome Viewer上でも表示できますが。
FPKM tracking ファイルと、Differential expression 結果ファイルの2種類があります。

1) FPKM tracking ファイル: トランスクリプトごとのFPKMを出力し、各cuffdiffランごとに4ファイルできる
isoforms.fpkm_tracking: Transcript FPKMs
genes.fpkm_tracking: Gene FPKMs.  同じgene_idを持つトランスクリプトのFPKMの積算
(cds.fpkm_tracking: Coding sequence FPKMs.)
(tss_groups.fpkm_tracking: Primary transcript FPKMs)

2) Differential expression 結果ファイル:  各cuffdiffランごとに4ファイル
isoform_exp.diff: Transcript differential FPKM.
gene_exp.diff: Gene differential FPKM.
(tss_group_exp.diff: Primary transcript differential FPKM)
(cds_exp.diff: Coding sequence differential FPKM)
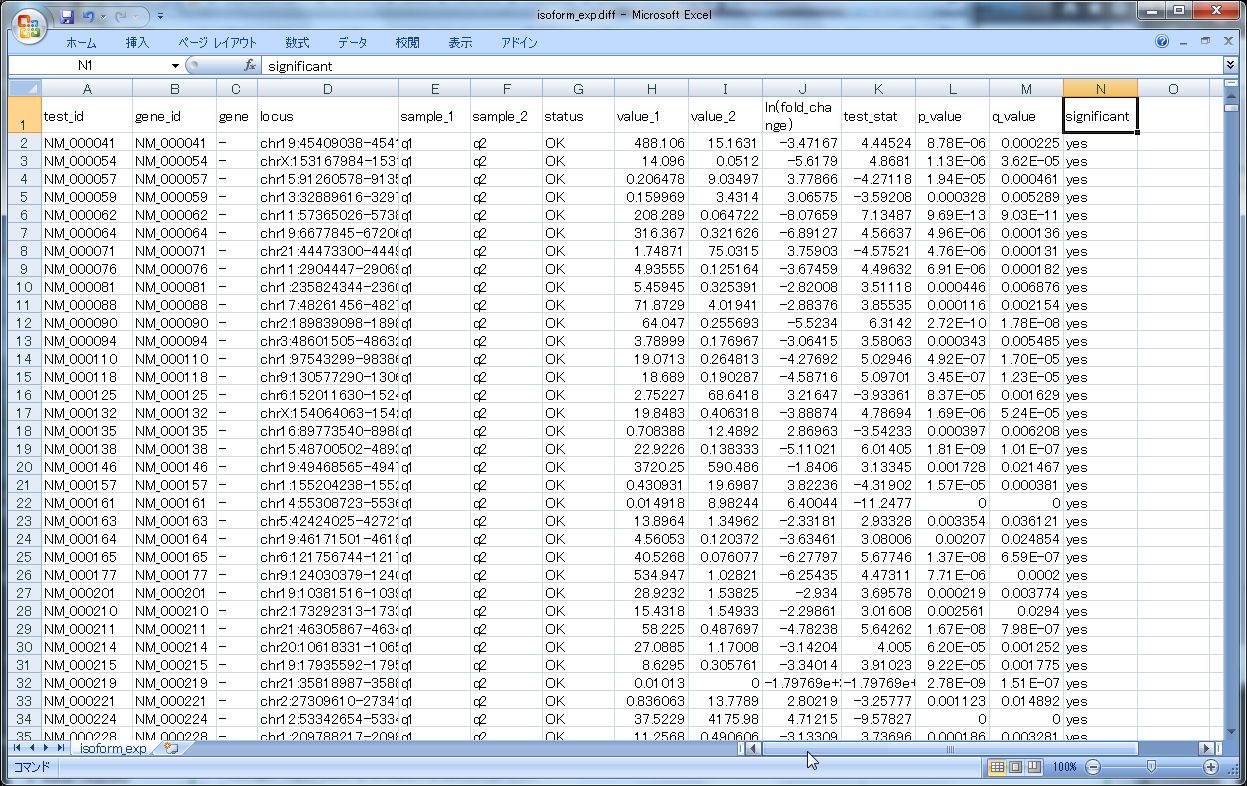
このうち、発現変動の結果ファイル、isoform_exp.diff をExcelで開いてみるとこんな感じです。
トランスクリプトのIDや名前、ポジション情報が先ずあり、そのあとHカラムくらいから、実際のカウンティングデータがきます。
  • FPKMx: FPKM of the gene in sample x
  • FPKMy: FPKM of the gene in sample y
  • ln(FPKMy/FPKMx):The natural log (自然対数) of the fold change y/x
  • test stat: FPKMの変動が有意であるかどうかの統計量
  • p value: 補正無しの p-value
  • q value: FDR-adjusted p-value
  • significant:"yes" or "no" マルチサンプル比較の場合はBenjamini-Hochberg補正後、FDR-adjusted p-valueが、cuffdiffランのパラメータ --FDR (デフォルト:0.05)より小さい場合は、"Yes" 有意だとされる
Ratioは、自然対数のログ表記という点にご注意ください。
また、Excelはsignificant = Yes で絞り込んでいます。

こんな風にして、RNA-Seq の実験データから、発現変動の有意な遺伝子を解析することができるのです。 
実際は、パラメータの調整などが必要ですが、感じはわかって頂けたと思います。

このあと考えられる操作は、
  1. 発現変動の有意だった遺伝子のポジション情報からBedファイルを作り、
  2. 先ほどソート済みのBAMファイルをGenome Viewerと一緒にとりこみ、
  3. ゲノム上で発現の変動と、マッピングの様子を同時に見る
ことでしょうか。 これはまた、Viewerに関する書き込みのときに詳しく説明します。

つづく


2011年6月2日木曜日

発現解析パイプラインを作るぞ! その1: TopHat の使い方

TopHatといえば、NGS発現解析で良く使われるツールです。
論文やポスターでも頻繁に見かけるので、一応、スタンダードなツールと見て良いでしょう。
TopHatと一緒にCufflinksという名前も、聞いたことがあるのではないでしょうか?
こちら、セットで使うと、RNA-Seqの解析にそこそこ威力を発揮します。

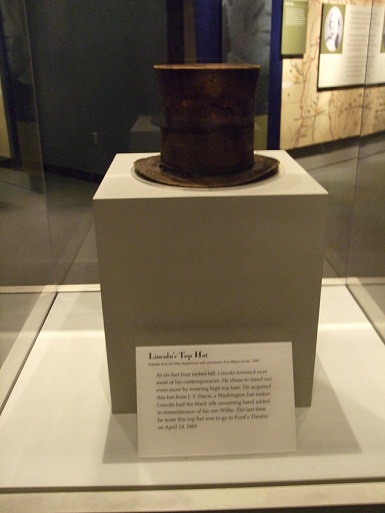
ちなみにこの写真は、エイブラハム・リンカーンが、実際に使っていたTopHatです。
スミソニアンのアメリカ史博物館での一枚です。
残念ながらCufflinks(カフスボタン)は、飾っていませんでした。
冗談はさておき、TopHatは、Exon-Intronのジャンクションを挟んでうまくアライメントするマッピングツールです。 Cufflinksは、そのマップされたフラグメント(リード)をカウントするツールです。
Cufflinksはこちらから(http://cufflinks.cbcb.umd.edu/)
ダウンロードできます。 マニュアルもあります。 Cufflinksは最近頻繁にバージョンアップされています。
TopHatを使うには、Bowtie(高速マッピングツール、http://bowtie-bio.sourceforge.net/index.shtml)
と、Samtools (SAM<->BAMファイルの変換やSNP検出などをするツール、http://samtools.sourceforge.net/)も一緒にインストールしておくと便利です。

Bowtie、TopHat、Samtoolsは、インストールも比較的難なくできますが、Cufflinksはちょっと準備が必要(bjamとかいうエンジンを入れる必要)ですので、行き詰ったらLinuxに詳しい方に助けを乞いましょう。 

4つともうまく入ったら、どんな風に動くのか、早速試してみましょう。
デモデータは、SRAから落としてきたSRP003186のデータを使います。 乳がんサンプル、イルミナGAIIのペアエンドデータです。
そうそう、SRAのファイルは、そのままでは解凍できないので、SRAのサイトからSRA-TOOLSというものを落としてきて、Linuxマシンにインストールします。 詳しくは昨年12月の書き込み(サンプルデータの取得法 2 NCBI 、http://shortreadbrothers.blogspot.com/2010/12/ncbi.html)にあるが、ここでのコマンドはfastq-dump2 から現在 fastq-dump に変わっているので注意!


全体の流れを示します。既知トランスクリプトーム情報を使った、発現変動解析パイプラインの大まかな例です。 必要以外のジョブもありますが、そこはつっこまないで。
  1. リファレンス配列Hg19を用意する
  2. Hg19に対してBowtieのインデックスを貼る
  3. TopHatを実行、リファレンスにマッピングする
  4. できたBAMファイルをソートしておく
  5. 後でViewerで見やすいようにソート後のBAMファイルにインデックスを貼る
  6. ついでにソートしたBAMファイルをSAMファイルにもしておく
  7. そのまたついでにソートしたBAMファイルをもとに、リファレンス配列と比較して異なる塩基(変異)のポジションを見つける
  8. さっき4でソートしたBAMファイルから、既知トランスクリプトのGTFファイルをもとに発現比較する ― Cuffdiff 実行
さて、リファレンス配列は、UCSCのFTPから適当なfa.gzをダウンロードしてきて、展開。
24本の染色体だったら、24個のファイルができるので、それを cat *.fa > hg19.fa としてひとつのファイルにまとめる。
ついでに、UCSCから、好きなアノテーションファイル(GTFフォーマット)を落としてきます。
これについては、この画面を参照 

  
インデックスは、Bowtieのbuildコマンドで
bowtie-build /Path_to_reference/UCSC_hg19/hg19.fa ./bowtie_ref/hg19

いよいよTopHatの実行です。
先ほどのgtfファイルを用意して、以下のようなコマンドを流します。 3つのサンプルがあります。
コマンドは3行です。ペアエンドなので、それぞれ***_1.fastq ***_2.fastq というファイル名です。

tophat -r 100 -p 4 -G /Path_to_gtf/refGene.gtf -o ./tophat_SRP003186_Control /Path_to_bowtie_ref/hg19 /Path_to_read_file/Control/SRR064437_1.fastq /Path_to_read_file/Control/SRR064437_2.fastq
tophat -r 0 -p 4 -G /Path_to_gtf/refGene.gtf -o ./tophat_SRP003186_MCF7/Path_to_bowtie_ref/hg19 /Path_to_read_file/MCF_7/SRR064286_1.fastq /Path_to_read_file/MCF_7/SRR064286_2.fastq
tophat -r 100 -p 4 -G /Path_to_gtf/refGene.gtf -o ./tophat_SRP003186_SKBR3 /Path_to_bowtie_ref/hg19 /Path_to_read_file/SK_BR_3/SRR064441_1.fastq /Path_to_read_file/SK_BR_3/SRR064441_2.fastq

パラメータについて
-r:  inner mate distance 平均フラグメントの長さ-両側のリードの長さ。MCFの例の場合、フラグメント長は100塩基でリード長は50塩基なので、100-50x2=0
-p: 使用するCUP数(デフォルト:1)
-o: アウトプットファイルを書き出すディレクトリ
-G: gtfファイルの場所
このほかのパラメータについてはおいおい。 もちろんTopHatのウェブサイトにも情報はたくさんあります。

アウトプットファイルは、たくさんできるのですが、以下の3ファイルがとくに重要!というか、後はあまり見ません。
  1. accepted_hits.bam:BAM フォーマットのアライメントファイル
  2. junctions.bed:Exon Junction情報をまとめたファイルで、UCSC BED track フォーマット。ジャンクションは2つのBEDブロックから成り、"maximal overhang" で指定した数以上の塩基によって構成しているはず。スコアはアライメントの数を示す。UCSC ゲノムブラウザに表示できる
  3. insertions.bed / deletions.bed:insertions/deletions情報をまとめたUCSC BED tracksファイル。
    Insertions.bed の chromLeft は、Insertion直前の塩基を表し、
    Deletions.bed の chromLeft は、Deletionする最初の塩基を表している、らしい
 さて、ここまでいかがでしょうか?

つづく

2010年12月28日火曜日

BWA マッピングツール

BWA,Burrows-Wheeler Alignment Tool を、ひとから勧められたので試してみた。
このアライメント(マッピング)ツールは、ギャップを許してアライメントすることができる。
また、リード配列は全部が同じ長さである必要が無い。
ということで、SNPなどのバリアントを見つけるにはいいと、そのひとは言っていたのだが、ここは議論の余地が残るところだ。

さて、そんなことはさておき、さっそく実行ファイルをダウンロード
http://sourceforge.net/projects/bio-bwa/
http://sourceforge.net/projects/bio-bwa/files/

インストールするマシンはLinuxの64ビット。
ダウンロードしたら、以下のコマンドを投げていこう!
$ bunzip2 bwa-0.5.9rc1.tar.bz2 これは解凍ね
$ tar xvf bwa-0.5.9rc1.tar
$ cd bwa-0.5.9rc1/ ディレクトリに移動して、
$ make メークして、
$ sudo apt-get install bwa スーパーユーザー権限でインストール!

だ、だ、だ、、、、ってインストールが完了したら、準備OK
失敗したら、近くのLinuxマニアに助けを呼ぼう。

ここからが本題。

BWAはBurrows-Wheeler Transform (BWT)を基本としているアライメントツールで、ショートリード向けのものと、ロングリード向けのものの2種類がある。
ショートリード向けは200塩基未満のリード長を3%未満のエラー率で、ギャップを許すグローバルアライメントを行い、ペアエンドにも対応している。
ロングリード向けのものはBWA-SWといい、Smith-Watermanアルゴリズムに似たヒューリステッィクなアルゴリズムで高いスコアを見つけながらローカルアライメントを行う。 
ショートリードでもこのBWA-SWを実行できなくはないが、エラーは多くなる。

・・・なんて、いかにも前から知っていたような書き方をしたが、ここに書いてあるのを訳しただけ。
もっと詳しく知りたいひとは文献までさかのぼってみよう。

さて、ランの流れだ。 こんな感じで進む。

1.データを用意する
リファレンス配列はFASTAフォーマット
リード配列はFASTQフォーマット 今回は例としてイルミナ・ペアエンドのショートリードを使う。
ほかのフォーマットに対応しているかは?

2.リファレンスデータベースの作成
リファレンス配列のデータベースを先に作る必要があり、FASTAファイルに、indexコマンドを使ってインデックスを貼る。

3.アライメントコマンド実行
アライメントはalnコマンドで実行する。Suffix Arrayという検索アルゴリズムの原理を使ってひとつひとつのリードのベストヒットを検索するらしい。

4.SAMファイルへ出力
alnコマンドで作成したsaiファイルを基に、マッピングファイルSAMを作成する。
samse/sampeコマンドはSuffix Arrayのインデックスを染色体の位置情報に変換する。
シングルリードならsamse、ペアエンドリードなら、sampeを実行。
sampeだよ。sampleと打ってしまいそうなので注意!

それでは実例を

まず、リファレンスに対し、インデックスを貼る(ヒト染色体1番のみを例に)
$ bwa index -p ./work/humanCh1 -a is ./Path_to_directory/hs_ref_GRCh37_chr1.fa

重要パラメータ
  -p: アウトプットするリファレンスデータベースの名前
  -a: インデックスの種類を指定 -a is または -a bwtsw
isは簡単で速い。ただしリファレンス塩基数の5.37倍のメモリを必要とし、2GB以上のサイズのデータベースは作れない。
bwtswは、BWT-SWのため。2GBの制限が無いので、ヒトの全ゲノムでデータベースを作ることができる。ただし10MB未満のデータベースは作れないし、速度もISに比べて遅い。

こんなインデックスファイルができたかな?


リファレンスデータセットの名前をhumanCh1にしたので、以下、alnの後のデータベース名はhumanCh1 になる。

リードファイルは、SRR027863_1.fastqとSRR027863_2.fastqで、これはペアエンドのファイルだ。
ひとつずつ、アラインさせる。

$ bwa aln ./work/humanCh1 ./work/SRR027863_1.fastq > ./work/SRR027863_1.sai
$ bwa aln ./work/humanCh1 ./work/SRR027863_2.fastq > ./work/SRR027863_2.sai

アラインして、拡張子saiのファイルができたら、いよいよマッピングファイルSAMの作成。
これはペアエンドなので、sampe
$ bwa sampe ./work/humanCh1 ./work/SRR027863_1.sai ./work/SRR027863_2.sai ./work/SRR027863_1.fastq ./work/SRR027863_2.fastq > ./work/SRR027863_Ch1.sam
ちゃんとパスを通しておけば、もっとすっきりするけどね。
基本は、
$ bwa sampe 「インデックスデータベース」 「アラインファイル1.sai」 「アラインファイル2.sai」 「リードファイル1.fastq」 「リードファイル2.fastq」 > 「マッピングファイル.sam」
これでSAMファイルは出来上がる。1.26Gくらいのでかいファイル。

今回は、シンプルにデフォルトで行った。
全部通しでも1時間くらいで終わった。

気をつけるとしたら、ショートリード用のリファレンスインデックスをつくるには、2GBのサイズ制限があるので、そのままヒト全ゲノムは使えないということ。
染色体ごとに分けるか、目的に応じて、いらない配列を削るかする必要があるかな。


2010年12月7日火曜日

マッピング、マッピング、マッピング

しつこいけれどまたマッピングの話。

ショートリードをリファレンス配列に対して貼り付けることを、マッピングと呼ぼう。
単に言葉の違いだと思うが、これをアライメントと呼ぶこともある。
はたまた、アセンブルと呼んでいる文献もある。

えっ!? ショートリードを貼り付けることがアセンブルだって!?

と驚いた方もいるかと思うが、2つ以上の配列の一致する箇所を並べて長いコンセンサス配列を作ることがアセンブル。なら、ショートリードと、リファレンス配列をアラインさせることだって、広い意味でアセンブルだ。 というひともいるのだ。 

ま、それはさておいて、ここではマッピングと呼ぶ。 
正確には、「リファレンスへのショートリードのマッピング」

で、デノボアセンブルを除くと、マッピングが全ての出発点なのだが、このマッピングのアルゴリズム、一体どれだけ正確なのだろうか?
というか、ショートリードのマッピングって、どれだけ信頼できるのだろう。

Illumina社の付属ソフトCasavaで使われているELANDv2にしろ、CLC-BioやNextGENet等有償ソフトにしろ、良く使われているアルゴリズムは、クオリティの高い塩基を十分に含むリード i.e. ちゃんと読めているリード を、リファレンス配列とのギャップがいくつ以上、ミスマッチがいくつ以上あるものを除いて、残りをマッピングしているに過ぎない。
つまり、ギャップがいくつあったらいけないよ。ミスマッチがいくつあったら同じと認めないよ。という決め事を先に設定し、それに沿ってショートリードの塩基配列がどこにヒットするかを求めているのである。

実に単純なアルゴリズムである! 
というか、これくらい単純にしないと数千万、数億のリード配列を今のコンピュータでは手軽にマッピングできない。
宿命ではあるが、その単純さゆえに、ミスアラインもあるだろう。 
本来マッピングされるべきでない場所にマッピングされる現象は、起こりうる。
それを防ぐには、Paired Endで読むのが良いとか言われるが、これは実験レベルの解決法だ。

ちなみにロッシュ454のロングリードは、僕は経験がないが、聞いた話ではBLATでもマッピングできるそうだ。 BLASTは時間がかかるという。 これは想像がつく。

ショートリードに話を戻すと、ミスアラインの問題は、実はそれほど気にしていない。
ショートリードのマッピングなんてそんなものだ、と思っている。
実験には、そういう覚悟も必要である。
パラメータをいくらいじったところで、ミスアラインが全く無くなることはありえなく、現在のショートリードのマッピングアルゴリズムが単純である限り、その信頼性はBLASTのe-valueほどはっきりと提示してくれない。
ショートリードのマッピングなんてそんなものだ。その代わり、大量のデータをParied Endで出力することで、ミスアラインの可能性を低くする。
しかしデータが大量になればなるほど、マッピングアルゴリズムは単純である必要があるのだ。
堂々巡りになってしまった。

このあたり、ロングリードのロッシュの担当者、ショートリードのライフテクノロジーズ担当者、イルミナ担当者と話をすると、それぞれ全く異なる見解が聞けて面白いと思う。

2010年11月26日金曜日

マッピングツールの種類

ショートリードの解析は、つまるところ
1.リファレンスが無いデノボアセンブリ と
2.リファレンスがあるそれ以外
に分かれる。
1は、シーケンサー本来の使い方であり、王道なのだが、僕はちょっと退屈だ。 いまいちゲノムプロジェクトの魅力が感じられないのは、僕がまだ半人前の証拠か。

それ以外の解析、トランスクリプトームやエピゲノム、SNPやAllelic Imbalance などの方が興味を惹かれる。
これらの解析では通常リファレンスがあるので、マッピングが行われる。以前紹介したBowtieは、僕のお気に入りのマッピングツールだが、それ以外にも、BFASTやSOAPなどが良く論文に現れる。
けれどもやっぱり、ユーザーが最初に使ってみようと思うのは、シーケンサーについているソフトのマッピングツールではないだろうか。

SOLiDなら付属ソフト「BioScope」のGUIから選べる "Map Data" とか "bFast Map Data"
Illuminaなら同じく付属ソフト「CASAVA(キャッサバと発音)」の "Eland"

シーケンサーについているソフトなので、配列データをベースコールした後、そのままマッピングできるのが便利…だろう。 いずれにせよ、マッピングは精度と速さ、目的に応じた使い勝手、で選ぶべきなので、
1.シーケンサー付属のマッピングツール
2.Bowtieなどのフリーのマッピングツール
3.CLC-BioやNextGeneなどの有償パッケージソフトのマッピングツール

を試すのが最も良いと思う。
マッピングのアルゴリズムは、今やどれも遜色ない。というか、精度の差は優越付けがたい。
僕の場合、マッピングの目的は、短い配列をできるだけユニークにアラインさせることにある。
大抵の場合、ヒトゲノムに対して、なので、リファレンス情報に不自由はない。
ターゲットを決めたディープシーケンスのときがほとんどだが、たまにホールゲノムに対しての時もある。 
マッピングの後の解析は、SNPやInDelの検出、新規転写産物の検出、たまにChIP-Seqやメチレーション、だ。
転座解析は、まだやってないが、興味はある。

これらに必要なマッピングアルゴリズムは何だろう?
短い配列だから、ユニークにアラインさせることは難しいか?

短いと言っても、リード長、今や40、50は当たり前。 Pair Endで実験すればForwardとReverseの間のフラグメントの長さが決まっているから、その情報を頼りにユニークにアラインさせることは難くない。 以前、メーカーの人に聞いてみたが同じような答えだった。

読んだ配列に、ギャップがあった場合、リファレンス配列にちゃんとマッピングされるか?
大丈夫、短いInDelならほとんどのツールが判別してくれる。
短いInDelとは例えば、IlluminaのCASAVAのEland v2 では20塩基未満のギャップなら認識してくれる。v2 以前はギャップは見落としていたらしい。

短い配列のマッピングには、ローカルアライメントが使われ、例えば連続する12塩基が完全に一致する箇所をリードの中に先ず見つけ、その後両端を伸長してアライメントさせるアルゴリズムがある。 
この方法は昔からよくChIP-Seqの論文で見つけた。 
伸長していくとき、同時に、ミスマッチの箇所、1塩基ギャップの箇所を見つけ、あればこれらでアライメントの精度を評価する。
評価にはスコアリングが使われる。 わかりやすく例えると、最初、50ベースのリードが、50点持っていたとする。 ミスマッチがあればマイナス3点、ギャップスがあればマイナス1点、などと50から減点していく。 ある程度の点数以下になればこのリードは信用なし、としてアライメントに使われない。 
正しくはツールによってスコアの種類も異なり、最初の12塩基完全一致という前提も異なり、計算式もそれぞれだ。 でもわかりやすく言うとこんな感じで、スコアリングについては、どのマッピングツールも大体似たような考えを用いて精度を上げている。

速度はどうか? 僕の体感ということを断わっておくと、
Bowtieはダントツに速い。
次にCLC-Bioが速い。
もちろん、他のフリーソフトも、条件を最適にすればそれなりなのだろうが、それを怠っているせいで、あまり速くは感じない。 
シーケンサー付属ツールは、実はガッツリ使っているわけではないのでわからない。

使い勝手はどうか?
これはその人それぞれ。
シーケンサーが外部のラボにあって、実際に触れない人なら、シーケンサー付属のソフトという選択肢は先ず消える。ということなら、フリーツールか有償パッケージソフトになる。
有償パッケージソフトが安定しているのは当然だ。
コマンドラインに格闘する楽しさは味わえないかもしれないが、SAMファイルを出してくる所までは簡単にできる。 パラメータ設定も十分種類がそろっている。 アルゴリズムもほとんど世界共通なものを使用しているので、心配はいらないと思う。
フリーツールも、コマンドラインを使って見せて、頭よさそーに自己陶酔できる、という利点もさることながら、SAMファイルまではちゃんと出してくれるだろう。 Linuxに詳しければシェルを組んでバッチで流すということもできるツールが多い(つまりマッピングの自動化)。

SAMファイルまたはBAMファイルまで出てくれば、マッピングツールとしての役割は終わりだ。
このファイルはその後のトランスクリプトーム解析、SNP解析、エピゲノム解析のスタートポイントになる。 まさに、マイクロアレイで言えば、ノーマライズ後のデータ、に似てはいないか。

2010年11月10日水曜日

SAMファイルをとりあえずビューワーで見る

Bowtieなどのマッピングツールでリード配列をリファレンス配列にマッピングすると、SAM (Sequence Alignment Map) というフォーマットのファイルができる。
SAMは実際、マッピングファイルの世界標準になりつつある。
サイズは、かなり大きい。 中身を見てどうこうということは無いけど、先ず、リファレンスに使った配列の情報がずらっと並ぶ。 @SQ SNから始まり、LN:の前までの、例えばgi|224589801|ref|NC_000010.10|が、リファレンス配列の名前だ。ちなみにこれはヒト10番染色体。
@HD VN:1.0 SO:unsorted
@SQ SN:gi|224589801|ref|NC_000010.10| LN:135534747
@SQ SN:gi|224589802|ref|NC_000011.9| LN:135006516
@SQ SN:gi|224589803|ref|NC_000012.11| LN:133851895
@SQ SN:gi|224589804|ref|NC_000013.10| LN:115169878
@SQ SN:gi|224589805|ref|NC_000014.8| LN:107349540
@SQ SN:gi|224589806|ref|NC_000015.9| LN:102531392
@SQ SN:gi|224589807|ref|NC_000016.9| LN:90354753
@SQ SN:gi|224589808|ref|NC_000017.10| LN:81195210
@SQ SN:gi|224589809|ref|NC_000018.9| LN:78077248
@SQ SN:gi|224589810|ref|NC_000019.9| LN:59128983
@SQ SN:gi|224589800|ref|NC_000001.10| LN:249250621
@SQ SN:gi|224589812|ref|NC_000020.10| LN:63025520
@SQ SN:gi|224589813|ref|NC_000021.8| LN:48129895
@SQ SN:gi|224589814|ref|NC_000022.10| LN:51304566
@SQ SN:gi|224589811|ref|NC_000002.11| LN:243199373
@SQ SN:gi|224589815|ref|NC_000003.11| LN:198022430
@SQ SN:gi|224589816|ref|NC_000004.11| LN:191154276
@SQ SN:gi|224589817|ref|NC_000005.9| LN:180915260
@SQ SN:gi|224589818|ref|NC_000006.11| LN:171115067
@SQ SN:gi|224589819|ref|NC_000007.13| LN:159138663
@SQ SN:gi|224589820|ref|NC_000008.10| LN:146364022
@SQ SN:gi|224589821|ref|NC_000009.11| LN:141213431
@SQ SN:gi|224589822|ref|NC_000023.10| LN:155270560
@SQ SN:gi|224589823|ref|NC_000024.9| LN:59373566
そしてBowtieのパスが書かれていて、そのあとから、各リード配列のマッピング情報がダーッと書かれるわけ。
1279_2_116_F3 4 * 0 0 * * 0 0 CCGTACGTCGTGGGTAGGGGCNGTGAGTCGCTTCGGGTCGAGGATCTGG =;?89,:4:=2,57-&*'&&/!,)&/.&),49,'1)-)'(,12+//-7) XM:i:0
これは人間が読むわけでは無いので、どうしても意味が知りたいひとはここを参照。
http://samtools.sourceforge.net/SAM1.pdf

さて、このファイルをとりあえずフリーのビューワーで見てみよう。
例として、IGV (Integrative Genomics Viewer)で見てみる。
登録(無料)してからダウンロードする。これはWindowsで動くので敷居が低い!

ところでさっきのSAMファイル、リファレンスの名前がgi|224589801|ref|NC_000010.10| のようになっているが、このままではIGVが認識しない。
ビューワーが認識できる染色体名に変換してあげなくてはいけない。
IGV なら、gi|224589801|ref|NC_000010.10| は、10 に変換する。以下24本の染色体も同じ。
やり方は色々あるだろうが、一番簡単なのは、Perlスクリプトを使って、
perl -pe "s/gi\|224589801\|ref\|NC_000010.10\|/10/g" SD_Agilent_Exome_F3.sam > temp1.sam
perl -pe "s/gi\|224589802\|ref\|NC_000011.9\|/11/g" temp1.sam > temp2.sam
perl -pe "s/gi\|224589803\|ref\|NC_000012.11\|/12/g" temp2.sam > temp.sam
perl -pe "s/gi\|224589804\|ref\|NC_000013.10\|/13/g" temp.sam > temp1.sam
のような置換コマンドを24本分繰り返すと、最終的に全ての染色体名をIGV用の染色体名に置き換えることができる。 こんな感じになった。

@SQ SN:10 LN:135534747
@SQ SN:11 LN:135006516
@SQ SN:12 LN:133851895
@SQ SN:13 LN:115169878
@SQ SN:14 LN:107349540
@SQ SN:15 LN:102531392
@SQ SN:16 LN:90354753
@SQ SN:17 LN:81195210
@SQ SN:18 LN:78077248
@SQ SN:19 LN:59128983
@SQ SN:1 LN:249250621
@SQ SN:20 LN:63025520
@SQ SN:21 LN:48129895
@SQ SN:22 LN:51304566
@SQ SN:2 LN:243199373
@SQ SN:3 LN:198022430
@SQ SN:4 LN:191154276
@SQ SN:5 LN:180915260
@SQ SN:6 LN:171115067
@SQ SN:7 LN:159138663
@SQ SN:8 LN:146364022
@SQ SN:9 LN:141213431
@SQ SN:23 LN:155270560
@SQ SN:24 LN:59373566
さて、そうしてSAMファイルをIGVでも認識できるようにしたら、インストールしたIGVを立ち上げてみよう。
そうしたら、次に、File > Run igvtools... で IGV tool を起動する。
そこで先ず、さっきのSAMファイルを染色体ごとにソートする。 CommandでSortを選び、リファレンスの名前をIGV用に置き換えたSAMファイルを指定して、Runする。

その次に、インデックスを作成する。同じくIGV tool上にて、CommandでIndexを選び、今ソートした結果ファイルを指定する。
そうすると拡張子 sai のファイルができる。
ここまできたら、さあ、IGVで取り込もう!

File > Load File で、ソート済みのSAMファイルを指定すると、自動的にインデックスファイルも認識されて取り込まれるはずだ。
しかし、最初は何も見えないだろう。 こんな風に
染色体を適当に選んでから、ズームインしてみよう!

こんな感じに見える。

まとめ: SAMファイルは、ちょっとリファレンスの名前を変更するめんどくささはあるけど、フリーのビューワーでちゃんと見ることができる。

ビューワーについてはまた今度。

2010年10月31日日曜日

BOWTIE マッピングツール の使い方 2

Bowtie がインストールできてちゃんと動くことを確認した。

マッピングには、インデックスをつけた参照配列が必要だ。
実はBowtieのサイトから、インデックスを付けたゲノム配列を、ダウンロードすることができる。
塩基配列用のインデックス済みゲノムファイルと、カラースペース用のインデックス済みゲノムファイルの2種類ある。 ファイルサイズが大きいから注意!
ダウンロードしたファイルは圧縮されているから、bowtie のプログラムがあるディレクトリの、indexes ディレクトリの中で解凍しよう。 そうすると.ebwt拡張子のファイルが6つできる。
これがインデックス済みのゲノム配列ファイルだ。

さて、indexes ディレクトリにインデックス済みゲノム配列ができた。
いよいよbowtieによるマッピングだ。 コマンドはbowtie
すべてのパラメータはマニュアルに書いてあるけど、初心者は、
-p CPUのコア数
-C color spaceのとき(デフォルトはfastq)
csfastaファイルの時は、-f でcsfasta、-Qでクオリティファイルを指定する
--sam SAMのフォーマットで出力する
--best 見つかったたくさんのマッチの中で一番ミスマッチが小さいアライメントだけを出す
-1,-2 ペアエンドの時のファイル
これだけ覚えれば大丈夫。

例えば、
bowtie -p 4 --sam -C --best hg19_c -f /(Readファイルがある場所)/val_20090928_2_Agilent_6_Exome_F3.csfasta -Q /(Readファイルがある場所)/val_20090928_2_Agilent_6_Exome_F3_QV.qual ./work/SD_Agilent_Exome_F3.sam

これは、SOLiDのウェブサイトから頂戴したサンプルデータ
val_20090928_2_Agilent_6_Exome_F3.csfasta と
val_20090928_2_Agilent_6_Exome_F3_QV.qual を、リードファイルとして、
ダウンロードしてきたインデックスファイル hg19_c をリファレンスに使って、
workディレクトリの下に、SAMファイルで出力するコマンド。
インデックスファイルのパスは指定する必要ない。

ちなみにbowtieのウェブサイトからダウンロードできるインデックス済みリファレンスゲノムは、ミトコンドリアのゲノムが含まれている。
染色体の名前は、chr1, chr2,.... となっている。 僕はそれだと使った染色体のアクセッションがわからないので、NCBIから落としてきたゲノム配列を元に、bowtie-build コマンドでインデックスを付けて、リファレンスに使っている。

そう、bowtie には、用意されたインデックス済みゲノム配列を使う以外にも、自分で集めた配列にインデックスを付けて参照配列にすることもできる。
NCBIのゲノムはここ。 ftp://ftp.ncbi.nih.gov/genomes/H_sapiens/Assembled_chromosomes/ ヒトの場合、hg19 は GRCh37なので、
hs_ref_GRCh37_chr1.fa.gz
とかを、1~X,Yまで、落としてきた。
24本全部のファイルを、1つのFASTAファイルに結合して、参照ゲノムファイルを作った。
そして、例えば
bowtie-build -C /(fastaファイルがある場所)/hs_ref_GRCh37_all.fasta ./indexes/hs_ref_GRCh37_c
(カラースペース用の参照配列をつくるときは bowtie-build -C  って、-C を付ければOK! ヌクレオチド用なら -Cはいらない)
reference_name のところは、インデックス済み参照配列の名前になるので任意の名前を付ける。 とにかく、インデックスを付けるのには数時間かかるときもあるので、オーバーナイトで流すのがいい。

hg19 のインデックスファイルでも最初はいいので、自分のデータ、またはNCBIのSRAから落としてきたfastq ファイルなどをとりあえずマッピングしてみよう!
SAMファイルができるはず。
そのSAMファイルは、そのままでは面白くも何ともない。
ここから先は、3次解析になる。
でも、3次解析に移る前に、SAMファイルをちょっといじってみよう。 ・・・つづく

2010年10月29日金曜日

BOWTIE マッピングツール の使い方 1

次世代シーケンサーのデータ解析は、発現解析、メチレーション解析、変異解析、などなどたくさんある。 
良く言われる、1次解析、2次解析、3次解析という定義は、以下の通りだ。
1次解析: ベースコールなどのリード自体のクオリティチェック。 シーケンサーに付属するソフトが自動的にやってくれることが多い。 デフォルトでOK
2次解析: リード配列の、参照配列に対してのマッピング。 参照配列は例えばゲノム配列。
3次解析: マッピングされた情報を元に行う、発現量推定や、メチル化部位の特定、SNPのDetectionなどの解析。
ちなみにデノボアセンブリは参照配列が無いので、1次解析以降のリード配列を使ってアセンブルする。

さて、では、デノボアセンブリ以外の場合、リード配列ファイルを手にしたら先ず行うべきはマッピングだ。 マッピングソフトはここhttp://seqanswers.com/forums/showthread.php?t=43にリストされているように、たくさんある。
有名なフリーのソフトでは、MAQ、Bowtie、BWA、ELAND
ELANDはイルミナシーケンサーのソフトに付属されている。 
Bowtieはカラースペースの配列もヌクレオチド配列も、ペアエンドもマッピングできて、とにかく速い。
MAQはSNP/DIPの検出に優れているらしい。
BWAも引用文献が多いのでそれなりに評価が高い。

結果を比べてみたことは無いけど、僕はBowtieに今はまっているので、今日はそれについて書く。 ちなみに、Bowtieはボウタイと発音する。

Bowtieの文献はここ http://genomebiology.com/2009/10/3/R25 
ウェブサイトはここ http://bowtie-bio.sourceforge.net/tutorial.shtml

先ずはプログラムをダウンロード
Latest Release で問題ないと思う。
僕は64Bit Linuxのサーバーに入れたので、Linux用のバイナリ(上から4つ目)を落としてきた。
インストールは特に問題なく終わると思う。 
Windows版でもインストールは問題なかった。 (僕が64bit Linux に入れた理由は、Human Genomeなどの大きなサイズのデータを扱うからである。 Windowsではどれくらいのサイズのファイルがマッピングできるか、今度試してみる)

さて、インストールができた。
Bowtieのディレクトリには、bowtie プログラムとともに、index フォルダ、genome フォルダ、などがあると思う。
ここで mkdir work などでワークディレクトリを作っておいて、その中にマッピング結果を入れるようにすると便利だ。

Bowtieがちゃんと動くかどうか、先ずチェックをしよう。
bowtie e_coli reads/e_coli_1000.fq
これをコピペしてエンターすると、ずらずらっとリードファイルが表示される これでOK
bowtie -t e_coli reads/e_coli_1000.fq e_coli.map
これの結果は、こんな感じ
ここに書いてあるのと同じ http://bowtie-bio.sourceforge.net/tutorial.shtml 

さて次は、いよいよBowtieを使ってマッピングする。 手順は、

1.ゲノム配列をもとにインデックスファイルを作る
2.インデックスファイルに対してマッピングをする
3.SAMファイルができるので、これを編集する

になる。 … BOWTIE マッピングツール の使い方 2へつづく