2011年9月23日金曜日

PacBio データの特徴 1

PacBioのシーケンサーから出てくるデータはどんなものなんだろう?

その前に、「4分でわかるPacBio-SMRTテクノロジー」をYouTubeで見つけたので、SMRTって何だ?ってひとはまずはここから。

テクノロジーについてもっと詳しく知りたい方は、PacBioのホームページか、この論文がお勧めです。
Schadt et. al., "A window into third-generation sequencing". Hum. Mol. Genet. (2010) 19 (R2): R227-R240
SMRTの特徴は、DNAを1分子単位で、PCRによる増幅無しで、結構長く読めるということです。
Single Molecule Real Time の略です。

ガラススライド上に無数の小さなポケット(ZMWs (zero-mode waveguides) )があり、その穴の底には、DNAポリメラーゼが固定されています。 この穴は非常に小さく、波長600nmまでの可視光線は通り抜けできない構造になっています。

シーケンスは、プライマーがアニールされたDNA鋳型がポリメラーゼに取り込まれ、反応準備が完了します。
4種類の異なる蛍光の付いた塩基が、ZMWsの外から入り込み、DNA鋳型に取り込まれると蛍光が切り離されてZMWsの穴の底で光ります。その光は底から30ナノメートルまでしか届きません。
スキャナーはその光を検出します。 底にはポリメラーゼが固定されているので、その近くで観測される光は、取り込まれた塩基による光しかない、というわけです。

でもランダムにZMWsの外からも蛍光付きの塩基が入り込むので、偶然ポリメラーゼ近辺に来て、蛍光が検出されてしまうことはないのでしょうか。 
IlluminaやSOLiDのような、蛍光検出一回につき余分な蛍光を洗い流す、Wash-and-Detectはしていません。 
あくまでもReal-Timeにポリメラーゼが自然に塩基がとりこまれるままで読んでいるのです。

トリックは、ポリメラーゼに塩基がとりこまれる速度はミリ秒単位、それ以外のZMWs内の塩基の出入りはマイクロ秒単位、という時間の差にあります。
ミリ秒単位で光らないと、DNA鎖の塩基として認識しないのです。


先日、Expression Analysis(http://www.expressionanalysis.com/)というアメリカの会社がPacBioのデータ解析Webセミナーをやっていたので、深夜2時だったけど参加してみました。
PacBioのデータって、どんなんだろう? すごく興味があったせいか、3時までずっと起きていました。 次の日会社・・・

さて、SMRTテクノロジーで検出される塩基は、ポリメラーゼがReal Timeに合成する速度と関係が深くなります。
ということは、塩基の検出される時間幅は、一定では無いということです。
Webセミナーの中でもそれを言っていました。
同じAGCCATと読んでいても、ポリメラーゼは機械ではありませんので、1塩基読むのに時間のばらつきが生じます。 これが画像からのシグナル変換、いわゆる一時解析を複雑にしている原因なのです。
とは言っても、PacBioの機械・ソフトは、これを何とか解決しているのでしょう。 でなければ商品化していませんよね。

次は、PacBioのデータを解釈するにあたって絶対必要な、リード、サブリード、ダンベル型のSMRTBellテンプレート、について説明します。


2011年9月10日土曜日

NGSでmicroRNA 2

前回はNGSでmicroRNAを読むときの一般的なワークフローで、マッピングまで書きました。

既知のmiRNA配列にマップしたときは、その発現量がマップされたリードの本数で表現できる、ということは直感的にわかるでしょう。
以前、RNA-Seqの発現量推定のところでも書きましたが、リードの数はサンプルごとのノーマライズ(正規化)が必要です。

(その既知miRNAにマップされたリードの本数)/ (そのサンプルランで取れた全リードのうちmiRNAにマップされたリードの合計数)

出力されたリードの数、特にマッパブル(Mappabl)なリードの総数は、サンプルによって異なります。 ですから、各miRNAにマップされたリードの本数を全体で割ってあげて、異なるサンプル間で比較可能にするのです。
分母を、そのサンプルのリード本数全体 として計算している方もおられますが、私は、マップされたリード本数全体 とした方が精度が上がると考えています。
だってマップされないリードまでノーマライズの分母に含めるのは不自然でしょう。

これだけでは値が非常に小さくなるので、100万倍して、RPM(Read Per Million)という表現にするのが良いかも知れません。

さて、そうして正規化された値は、当然ながらmiRNAの発現量そのものではありません。
あくまで比です。
ということで、この値は、ほかのサンプルの正規化miRNA発現値と比較して、何倍発現量が多い、少ない、というような解析に持っていきます。
マイクロアレイと同じですね。

Nが3以上あれば、正規化後の値を対数変換してから、通常の統計手法(T‐Testなど)で比較すると良いでしょう。

DESeqという発現量比較のツールも使えるかと思います。
いろいろ調べてみると結構miRNA関連論文で、このDESeqが使われています。 
元々は発現変動遺伝子を解析するツールです。 
遺伝子は全部で数万あり、その中でほとんどは変動していない、という仮定の下、変動有意遺伝子を見つけるわけです。
microRNAは全部でもたかだか数百、これで遺伝子発現と同じモデル(負の二項分布)式を使っても良いのか、という疑問は残りますが、ここではそれを置いておくとして。

Nが1しか無い場合、割り算して比較するしかありませんね。

有意な発現変動を示したmiRNAが見つかったら、そのターゲット遺伝子を探してみましょうか。
データベースとしてはまず、miRBase (http://www.mirbase.org)がいいでしょう。
ここからはTargetScan や Pictar といった、ターゲット予測プログラムのサイトへもリンクできます。
ターゲット遺伝子を見つけたら、その遺伝子のGO(Gene Ontology)を検索して、どんな機能の遺伝子がターゲットになっていたのか、を調べることも良く行われます。

さて、これら以外に、NGSならではの解析とは何でしょう?

そう、既知ではなく、未知のmiRNAを見つけることです。

それには先ず、マッピングのデータから、既知miRNA以外の場所にマップしたリードが作っている、ある程度の長さのクラスターを見つけてこなければいけません。
ある程度の長さって、どれくらいだ?
クラスター配列は、2次構造を取り得る、いわゆるpalindromicの配列でなくてはなりません。
1次元で言うと、(mature miRNA配列)+(ループ構造)+(mature* miRNA配列)のパターンである必要があります。
そのような配列を取ってきたら、エネルギーが最小になるようなときにちゃんとヘアピンのようにフォールドするかどうか、を確かめます。
さらに、Droshaなどのタンパク質に切断されるサイトがあるか、調べます。

これを全部プログラムを作って行うのは大変ですが、幸い、アカデミックの方ならフリーで使えるツールがあります。 miRDeep というものです。


このドラえもんの手、みたいなのがmature miRNA-Loop-star の2次構造で、薄い線がマップされているリードです。 
matureの方により多くのリードがマップされているのは、より本物らしいmicroRNAだったことを裏付けます。

残念ながら、企業はフリーじゃないんですよね。 いくらか払うのかな。

2次構造だけの予測なら、できるソフトもありますが、miRDeep ほど特化しているものは少ないでしょう。 チャンスがあれば使ってみたいです。


microRNAをNGSで解析するというテーマで、よくまとめられているレビューがあるので紹介します。
Motameny et al. (2010) Next Generation Sequencing of miRNAs - Strategies, Resources and Methods. Genes. 1, 70.

こちらはmiRanalyzerというツールのワークフローです。フローは参考にしています。
Stark et al. (2010) Characterization of the Melanoma miRNAome by Deep Sequencing. PLoS One. 5, e9685.

発現量比較から新規miRNA予測、ターゲットのGO解析まで行った例です。 こちらも良い。
Dhahbi et al. (2011) Deep Sequencing Reveals Novel MicroRNAs and Regulation of MicroRNA Expression during Cell Senescence. PLoSOne. 6, e20509.

2011年9月5日月曜日

NGSでmicroRNA解析 1

microRNAというのは、タンパク質にはならない、いわゆる non-coding RNAの仲間です。 
それ自身で標的のmRNAの3’-UTRなどに結合し、標的mRNAを分解します。
microRNAは発現制御機能を持った、RNA分子なのです。

と、ごくごく簡潔にまとめましたが、microRNAについては、多くのレビューや教科書に記載がありますので、詳しくは書かないとして。 Wikipediaでもかなり情報が得られますよ。


さて、microRNAの解析は、長らく、TaqManアレイやその他のマイクロアレイ、PCRなどが主流でした。
近年、NGSでもこれを解析している例が見られます。
実験プロトコールとして一般的なのは、
  1. トータルRNAを抽出して
  2. ゲルに流した後18-30塩基のあたりを切り出し
  3. Small RNAを精製して
  4. ライブラリーキットにある通りアダプターを付け
  5. cDNA合成し
  6. ライブラリーをシーケンサーで短めに読む
というものです。

短めに読む、というのはフラグメントの長さが 18-30塩基を予想しているからで、35、6塩基も読めば十分全体をカバーするからです。
ゲノムや転写産物を読む場合は、できるだけ長く読めたほうが良いですが、microRNAは短くてもOK、むしろちゃんと正確に読めることが大切です。

さて、シーケンサーが無事データを出力しました。
ここからデータ解析です。

microRNAの解析では、リードのアダプタートリミングは大切です。 (microRNAに限ったことではありませんが)
読んでいるフラグメントの長さが短い分、5’側のアダプターから読んだ時に、フラグメントを読み切り、3’側のアダプターまで読んでしまうことがあるからです。
そのため、3’側のアダプターをトリミング(除去)することが必須です。

次に、トリミングした後のリードが、短くなりすぎると、後でマッピングする際にNon Specificにマップされる恐れがあるので、これも除きます。 15‐18塩基以下の短いリードは除去するといいかもしれません。

リードがきれいになったところで、いよいよマッピングです。 でも何に対して?

一例を示します。 今度参考文献も示しますね。

  1. 先ずゲノムにマッピングし、マップされなかった配列はごみとして除去する
  2. ゲノムに当たったリードを回収、miRBase の配列(precursor, mature, mature*)にマッピング
  3. miRBaseの配列にぴったり当たったリードは、既知のmicroRNAとして保存
  4. miRBaseの配列に当たらなかったリードは、次に、microRNA以外の、既知のnon-coding RNA (piwiRNA, snRNA, snoRNAなどの) 配列に対してマッピング
  5. non-coding RNAにも当たらなかったリードは、念のため、RefSeqのmRNA配列に対してマッピング
  6. それでも当たらなかったリードは、新規microRNA「候補」として保存

これにより、①既知のmicroRNA、②それ以外のnon-coding RNA、③新規microRNA 候補、の3種類のデータセットができる。

既知のmicroRNA、non-coding RNA については、発現量の解析をすることになるでしょう。
新規候補の解析は、少しやっかいだが、アルゴリズムが無くはないのです。

つづく

2011年8月27日土曜日

SIFT SNP機能予測アルゴリズム

今日もSNVの話です。
1塩基の変異が、タンパク質にどんな影響を与え得るのか、の予測アルゴリズムです。
今までPolyPhenとかGrantham Scoreとかについて少し触れましたが、今日はSIFTというアルゴリズム&ツールについて。

"SIFT" ってググると、上位には画像検出アルゴリズムがたくさん出てきますが、これは違うので必ず、"SIFT SNP" とかで検索して下さいね。 (画像検出の方も興味がありますが)
http://sift.jcvi.org/
SIFTとは、Sorting Intolerant From Tolerant の略です。
???
そもそもtolerant とは何でしょう?
辞書で引くと寛容な、とか耐性、とかがあります。 
ここではタンパク質の機能に変化が無い、ということを意味します。


SIFTの考え方の基本は、配列保存性です。
同じタンパクファミリーの中で、保存性の高いアミノ酸配列があったとします。 
そのような配列の中のアミノ酸変異・置換は、タンパク質の機能に致命的な影響を与える可能性が高いと思います。 
機能を失ったタンパク質は、進化の過程で生き残れませんね。

反対に、タンパク質機能に重要な影響を与えない部分のアミノ酸ならば、進化の途中でどんどん置換が起こり得るだろうし、またそのような機能に影響の無い場所のアミノ酸置換は、生き残っているタンパク質にも見られるはずでしょう。

つまり、配列の保存性が高い場所のアミノ酸置換は、タンパク質機能の変化という点でIntolerant(影響あり)。
配列保存性の低い場所のアミノ酸置換は、タンパク質機能変化にTolerant(影響なし)。

この方法は、正しいタンパク質ファミリー(オーソログタンパク)を集めてアライメントすることが重要です。その中で配列保存性を見ていくからです。 
UniprotやNCBIのnrなどから配列データを借りています。

さて、このように配列相同性のみを使用した予測ツールでは、タンパク質の立体構造までは見ていません。 
ループ構造部分に変異があるのか、疎水性が失われるのか、といった情報までは見ていないのです。
これらは別の予測ツール(Polyphenなど)が必要です。

NGSでSNVを見つけた。
Non-synonymousのSNVを絞り出した。
次に考えるのは、そのnsSNVの重要性です。
そのアミノ酸が変わったらタンパク質として生き残れないよ、という情報は、重要性の指標になります。
そのアミノ酸が変わっても、タンパク質は生き残っていたのなら、その置換はさほど重要ではないでしょう。
最初にSIFTなどで、配列保存性を基準にnsSNVの重要性をフィルターにかけ、残った重要そうなやつを、次にタンパク質立体構造上で確認していく方が近道のような気がします。

さて、実際にNGSでSNVを見つけてからこのツールを使って解析するにはどうしたら良いか?
先にURLを示した場所よりも、以下から入る方がお勧めです。
VCFフォーマットをSIFT専用のフォーマットにコンバートしてくれるからです。

http://sift.bii.a-star.edu.sg/www/SIFT_intersect_coding_submit.html
ここで、SAMtoolsなどで求めたVCFファイルをアップします。
そうするとしばらくして、コンバートされたファイルができますので、これをPCに保存します。
SNP用のファイルと、InDel用のファイルの2種類できます。
ここではSNP用ファイルを例に、落とします。
保存したら、upload here のリンクをクリックして、そのファイルをアップロードします。
その時、自分のE-mail アドレスと、オプションでどんなアノテーションを付けたいかを指定します。
結果は、HTML、またはテキストで参照できます。
これがSNPの結果
リンクできるところはそれぞれのDBにリンクしています。
HTMLだと、ちょっと扱いにくいので、私はテキスト(tsv)で落として、Excelで見ることもお勧めします。
例えば、こんな風に絞り込めば、新規っぽいSNPの機能を予測できます。

この絞り込みの条件は、
  1. dbSNPに登録の無い "novel" SNPで
  2. アミノ酸置換をもたらす Non-synonymous SNP
です。 ここで、SNP-Typeの右の、Predictionカラムでソートして、DAMAGING(=Intolerant)を選ぶのです。
その時、ScoreとMedian Infoにも注目します。
Scoreは0から1の値を取り、0.05以下のとき、タンパク質機能に影響あり(=Intolerant = Damaging)とされます。
Median Infoは保存性の信頼度で、0から4.32の値をとり、大きいほど信頼度が低くなります。 3.25以上のときはLow confidenceとして警告が出ます。

どうでしょう? SNPの機能を調べるにはとても使いやすいツールだと思います。


 もっと詳しく知りたい方は、

 http://sift.jcvi.org/www/SIFT_help.html

Kumar P et al. Predicting the effects of coding non-synonymous variants on protein function using the SIFT algorithm. Nature Protocols 4, 1073-82 (2009).

2011年8月20日土曜日

Ensembl - Variant Effect Predictor でSNPアノテーション

先日、VCFフォーマットを読みこんでSNPのアノテーションを付けるツールとして、SeattleSeq Annotationを紹介しました。ここ

ちょっと調べると、ほかにもいろいろありますね。
今日は定番?のEnsembl です。
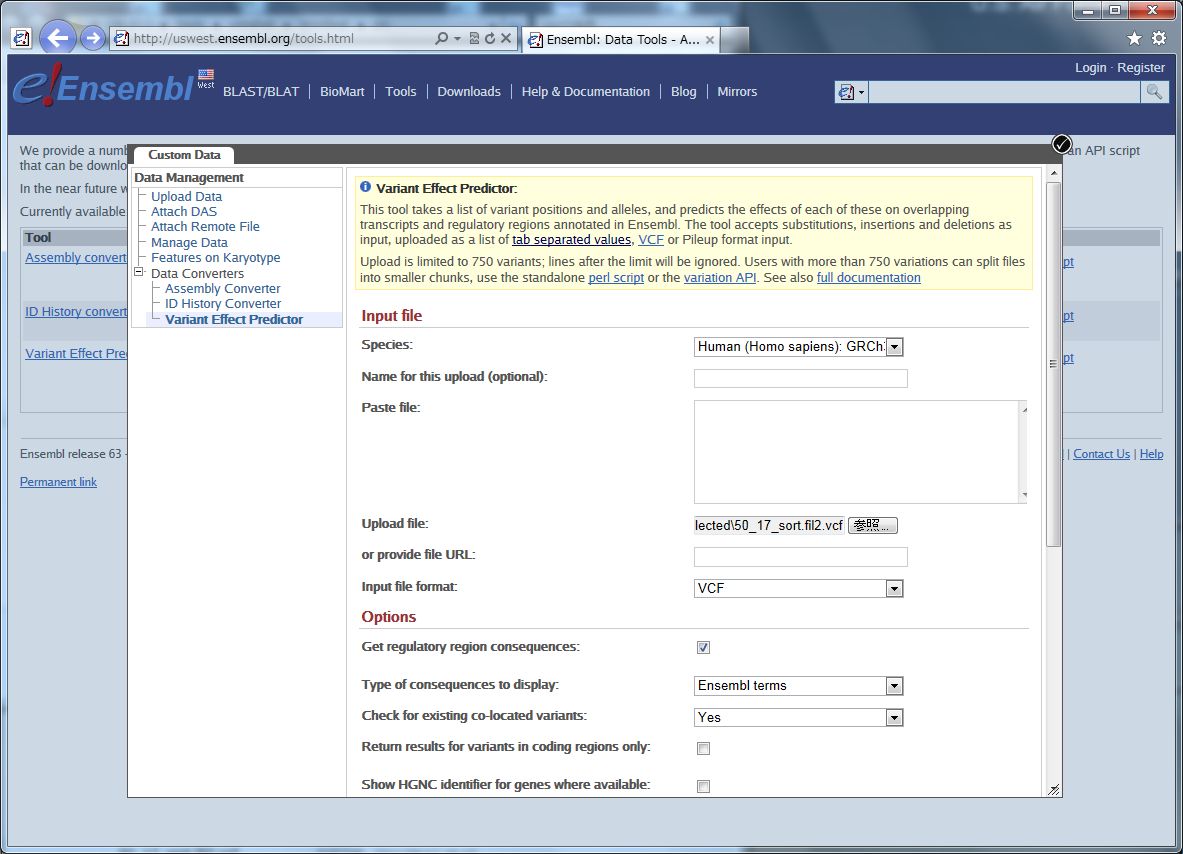
その中の、Variant Effect Predictor というウェブツールです。


Species は、ここではヒト。 ゲノムバージョンと一緒に選びます。
ファイルの場所を指定して、フォーマット(VCF)を選びます。 
もう気づいたかもしれませんが、私はVCFを読みこめるツールが好きです。
VCFは変異レポートファイルのデファクトスタンダード。
書き込める自由度も高く、ほぼ満足です。
VCF自体を人間が読むことはあまり無いでしょうが。


追加するアノテーションを選びます。
ここからはヒトのデータのみです。

Non-Synonymous SNP(アミノ酸コーディング領域で起こる一塩基変異で、コードされるアミノ酸を置換するもの)について、その影響を予測するために、SIFT、PolyPhen、の2種類のスコアをアノテーションします。

その下のフィルタリングオプションは、マイナー・アレル・フリークエンシー(MAF)で、データをカットできます。
Nextを押して実行すると、検索が始まります。
こんな画面がでたら終了。
HTMLを「別のタブまたは別画面」で開いてみましょう。 そのまま開くと前に戻れないので注意!

HTMLのレポート画面です。 
Ensembl-IDとか、SNVの遺伝子上の場所、変異のアノテーション、アミノ酸変異があるものはその機能への影響度合い、などがリストで表示されます。


すぐ上のスクリーンショットには、Coding領域にあるNon-Synonymous SNVがありますね。
SIFTとPolyPhenの値も右にあります。
SIFT=tolerated(0.07); PolyPhen=benign(0.16) 
このうちPolyPhenの値とDescriptionについては以前SeattleSeqのところでちょっと書きましたね。
SIFTについてはまた次回。

さて、HTMLのほかに、テキストでダウンロードもできます。
これは後で編集するのに便利でしょう。

もうひとつは、
Ensemblのゲノムビューワーへのリンク。私は使ったことはことがないですが。 こんな感じでSNVの位置がわかります。


このEnsembl Variant Effect Predictorですが、残念ながらウェブ上で行うにはデータ量MAX780変異と、制限があるそうです。
それ以上の変異を解析するには、Perl APIという手があります。


2011年8月18日木曜日

IGVがVCFフォーマットに対応!

うちのベランダでは、今年流行りの緑のカーテンを、ゴーヤとアサガオでやっています。
アサガオは去年の分子生物学会で、九州大学の方から分けてもらったいろんな原種を種から育てました。 白のアサガオがきれいです。

緑のカーテンはそれなりにいいんですが、うちのすぐ前には適当に木が生い茂る公園があるんですね。
そこから飛んできたセミが、うちの緑のカーテンに止まって、夜な夜な鳴き続けるんです。
深夜2時くらいまで鳴いています。
静寂をくれ~!

さて、IGV (Integrative Genomics Viewer http://www.broadinstitute.org/igv/ )のサイトを久しぶりに見てみたら、バージョンアップしていました。
Version2のベータだったのが、いつの間にかVersion2.0.4に!
こまめにチェックしなくてはいけませんね。

追加機能として個人的に良かったのは、VCF4フォーマットが取り込めること。
これでNGSデータからSamtoolsなどで検出してきた複数サンプルのSNPデータを、そのまま並べて表示できます。
ちゃんとソートしてから作ったVCFフォーマットを用意し、IGV toolsで、インデックスを付けるのを忘れずに。

こんな感じ。

2011年8月12日金曜日

制御領域はSNP検出に不向き?

遺伝子発現のオン・オフに重要な働きをする、CpG island と その多くが存在する5'-UTR
この部分はゲノムの他の部分よりGCコンテンツが高いことが知られています。
制御領域を次世代のシーケンサーで読んで、その変異を調べようという研究がありますが、それは注意が必要だ、というレポートを見つけました。

その名も、「Next generation sequencing has lower sequence coverage and poorer SNP-detection capability in the regulatory regions」 

このレポートでは、Cancer Genome AtlasからIlluminaとSOLiDのデータをダウンロードして、まずマッピングをたくさんのツールで行って比較しています。

比較しているのは、マッピングツールは
  • Bowtie
  • BWA
  • SOAP2
  • RMAP
  • ZOOM
  • Maq
  • Novoalign
  • SHRiMP
 SNP検出には
  • MAQ
  • SOAPsnp
  • SNVmix
です。
マッピングツールのサマリーは、サプリメント資料に詳しくあります。
Smith-Waterman alignment系、Burrows-Wheeler transform系、Hash Table系、とそれぞれ。

マッピングプログラムの比較をまとめた論文は良く見かけるのですが、このレポートでは単にどれが速い・低メモリー・高カバレージだ、というのにとどまらず、タイトルにもありますが、

GC%が高い制御領域は、ゲノムの他の領域と比べてマッピングカバレージが極端に低い
よってCpG island などの制御領域でSNPを見つけたいときは気をつけよ!

と言っています。

私も今まで、カバレージと言っても、ゲノム平均カバレージ、あるいは遺伝子平均カバレージにのみ注意が行って、遺伝子の中の5'-UTR, Exon, Intron, 3'-UTR と分けて考えたことは無かったのでなるほどと思いました。

ちなみにこのレポートでは、
  • BWT系のマッパー(Bowtie, BWA)がイルミナデータのマッピングには、ペアエンド、シングルリードのどちらでも最も成績が良かった。
  • SOLiDデータのマッピングには、NovoalignCSが最も良かった。
  • SNP検出はMAQが一番良かった。
と結論つけています。 ここは異論がある方もいるでしょうが。
ただ、なんとなくですが、無難な結論ではあります。